
Fluxo de trabalho Animate LTX-2.5 de imagem para vídeo
LTX-2.5 transforma uma imagem em vídeo com o som gerado na mesma passagem. O modelo entende linguagem natural, então não são necessárias tags especiais ou truques para obter áudio: descreva o que acontece e o que é ouvido. Vídeos longos em uma única execução são possíveis; o exemplo na página inicial é um clipe de 1200 quadros a partir de um único prompt. O aprimorador de prompt (/slot1:1) reescreve seu prompt com mais detalhes e melhora a qualidade geral.
Compatível / Disponível em Apps com Graydient
Renders de exemplo
Feitos com os modelos que este fluxo de trabalho executa, compartilhados por seus criadores no ModelTrends. Escolha uma miniatura para ver o render em tamanho grande com o prompt que o gerou.
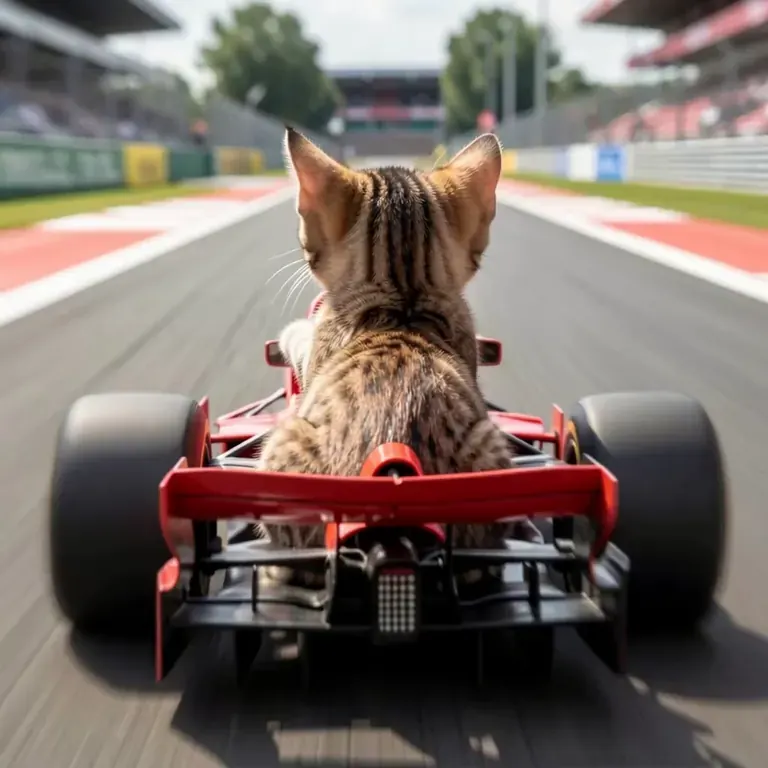
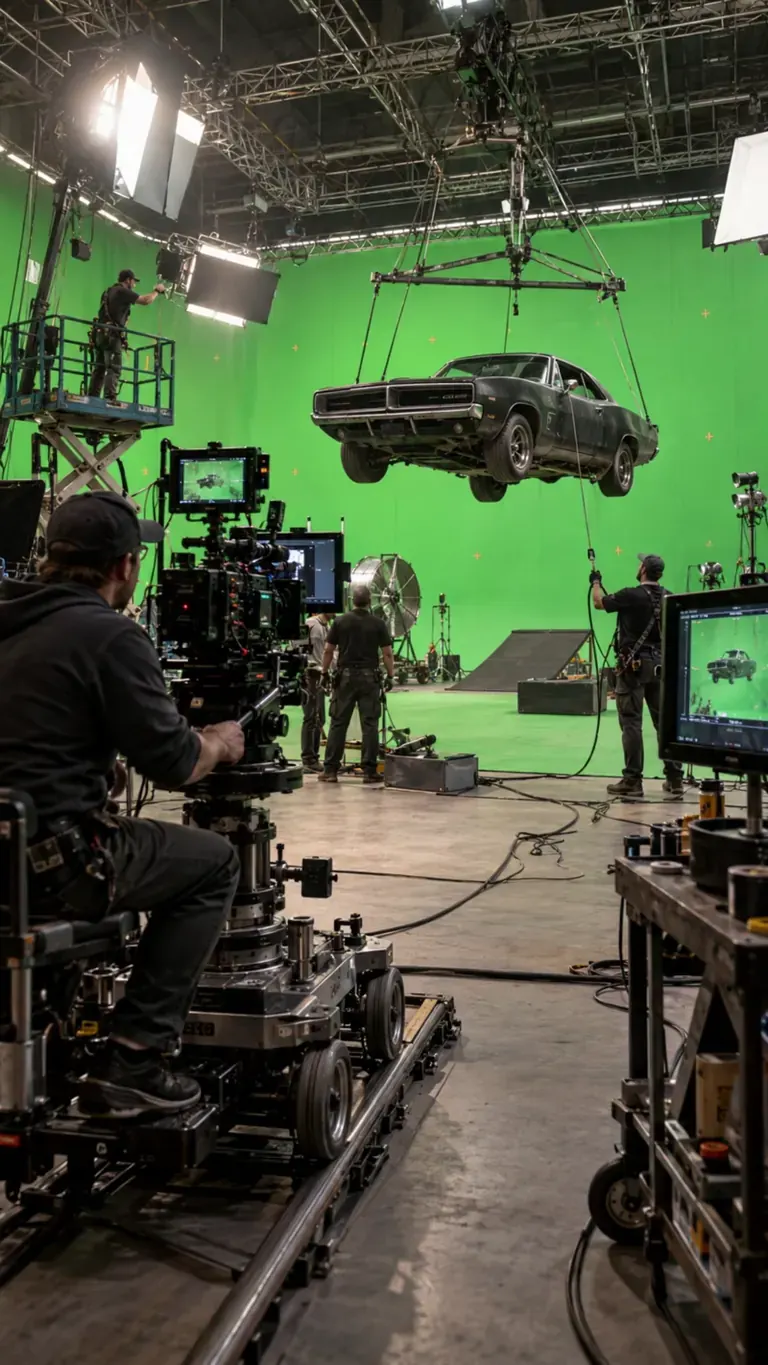
Render por Petishamiaou com (LTX-2 Lora) - Rally (Race) Driver POV Video
r4llyp0v, POV view of a kitten driving a formula1 car on a track at fast speed.
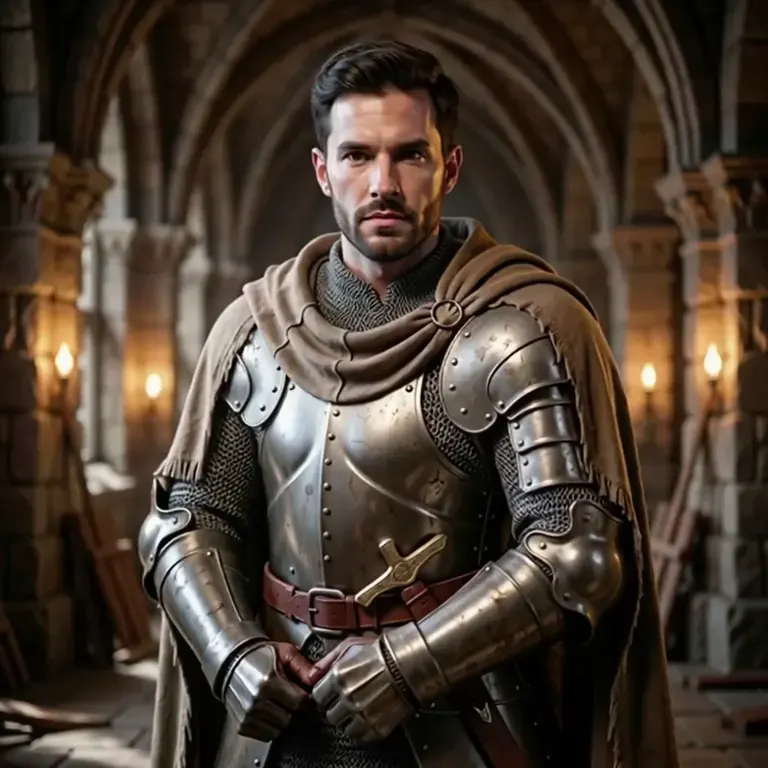
Render por kabachuha com Disguise Drop - LTX-2 / Wan2.1 14B FLF2V
Disguise drop. A knight in shining, bulky armor stands in a castle courtyard. He struggles to move, then has an idea. He unzips the chest plate, revealing not a man, but a clever miniature raccoon inside. The miniature raccoon pops out, drops the suit, and scurries off with a piece of stolen treasure.
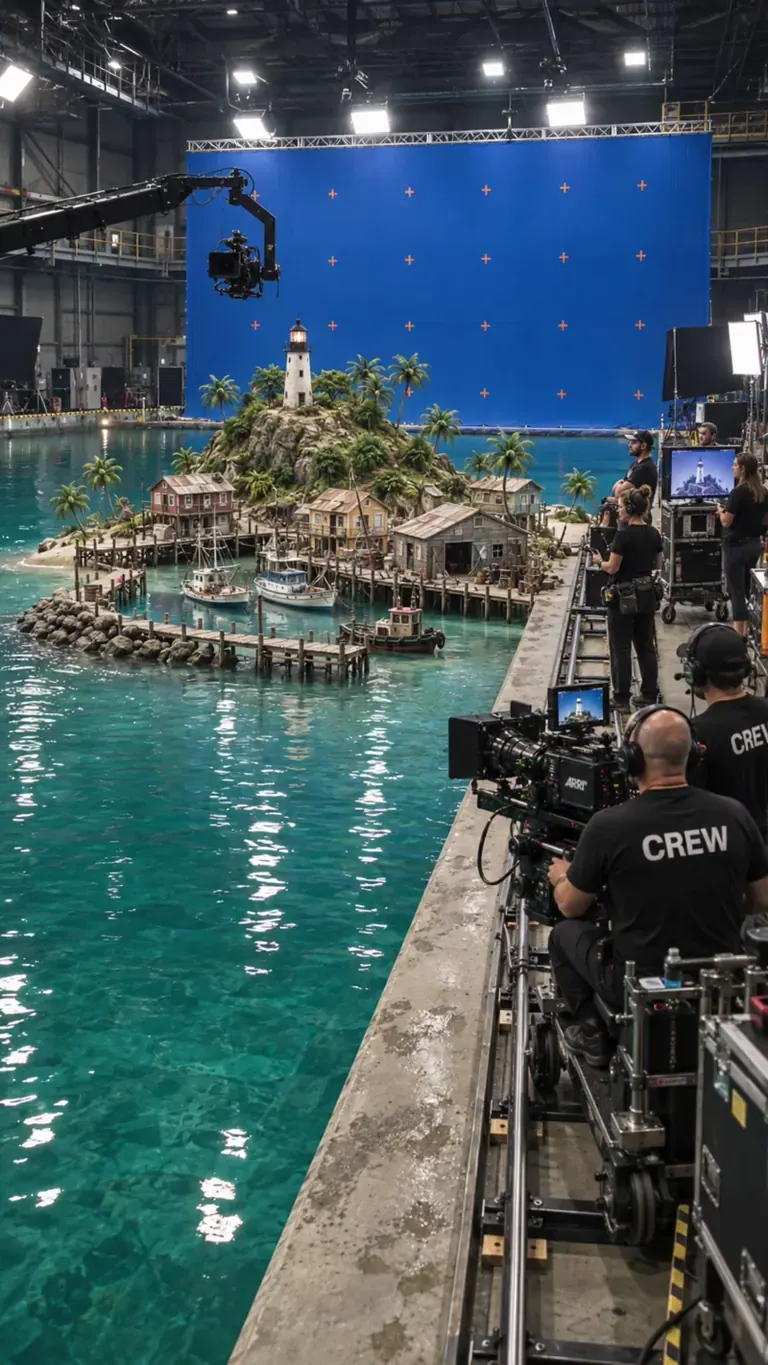
Render por Solricks com BTS Movie Set
btssetstyle, locked-off stationary camera, miniature water-tank film shoot. The off-screen director calls, "And... action!" as a wave-maker sends a realistic surge across the studio tank. The wave crashes into the miniature harbor, tossing scale boats and flooding the wooden piers with white foam. As the water dissipates into calm foam, the director calls, "Cut!" The camera crew in the foreground relaxes, smiles, and applauds the take. Realistic water physics, blue-screen soundstage, 4k photorealistic
Render por Solricks com BTS Movie Set
btssetstyle, Create a realistic behind-the-scenes vehicle stunt shoot. The suspended car moves very slightly on its rig with believable weight and inertia while crew members make natural adjustments around the set. The camera operator slowly moves the dolly along the track, technicians monitor the suspended vehicle, and the overhead rig remains stable. Keep all green-screen walls, stunt equipment, camera rigs and visible crew present throughout. Motion should be restrained, physically grounded and documentary-like, as if filmed during a real high-budget action production.
Render por kronos1959777 com Immediate Scene Transition [LTX 2.3]
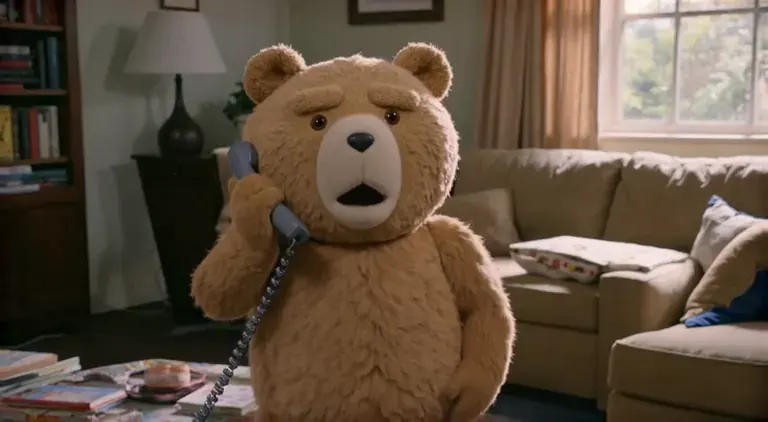
closeup of Ted_Bear in his living room on the phone saying, \"oh god, Jeffrey, you're in prison!?\" immediate scene transition to the same person (Ted_Bear) inside a prison visitor room talking to an unseen figure. After the scene transition, Ted_Bear is saying, \"Oh, Jeffrey, thank god you're doing okay. Are they treating you well here? I can't imagine my good friend Jeffrey ending up in a place like this. You've always been so good to people, especially ***.
Prompt by playtime_ai_ · Gollum - LTX-2
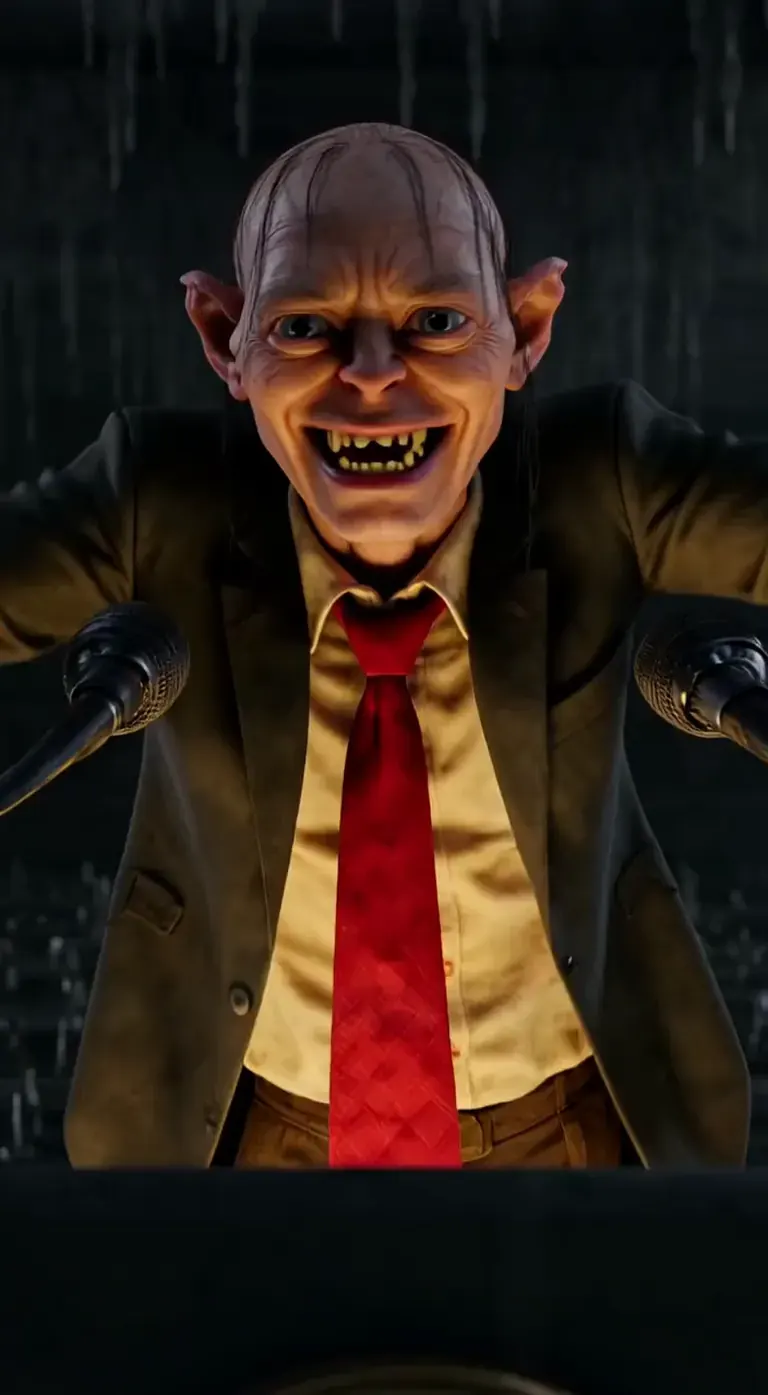
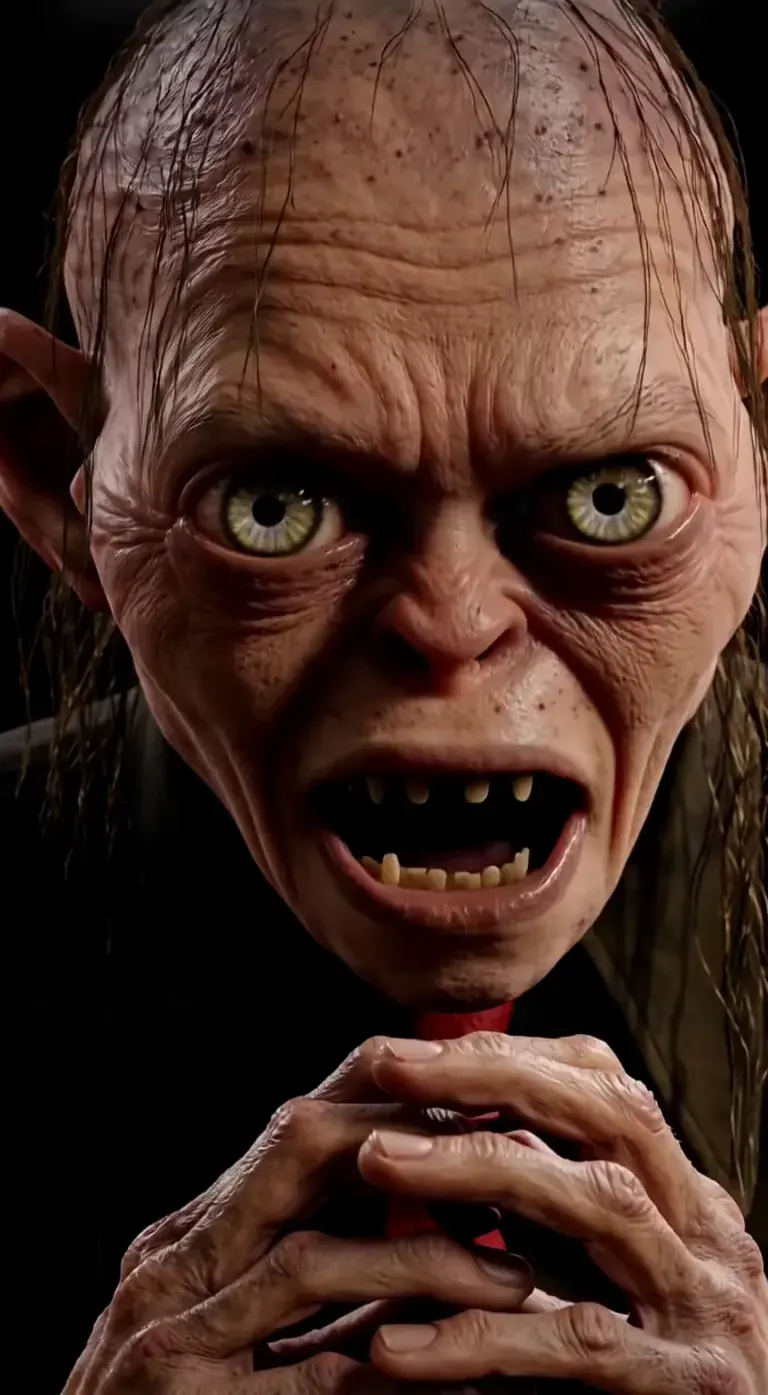
Every time I hear trump speak, this is how I see it in my head... It really isn't fair to Gollum though. At least Gollum has redeeming qualities. Anyway, Donald Trump really said this dumb shite. Enjoy!
Render por playtime_ai_ com Gollum - LTX-2
Every time I hear trump speak, this is how I see it in my head... It really isn't fair to Gollum though. At least Gollum has redeeming qualities. Anyway, Donald Trump really said this dumb shite. Enjoy!
 Renders e prompts do ModelTrends, o catálogo de modelos de IA para imagem e vídeo.
Opções
| Opção | Mapeia para | Padrão |
|---|---|---|
(image) | Load Image → image | — |
(prompt) | CLIP Text Encode → text | — |
/guidance | KSampler → cfg | 3 |
/length | LTXV Img To Video → length (frames) | 1200 |
/seed | KSampler → seed | random |
/size | LTXV Img To Video → width, height | 640 × 640 |
/slot1 | Prompt Enhancer → enhance (1 = on) | 0 |
/steps | KSampler → steps | 30 |
Modelos usados
 Animate LTX-2.5
Modelo importado pelo shortcode
/run:animate-ltx25 do ModelTrends
Veja no ModelTrends
Para Desenvolvedores (opcional)
Exemplo de trecho de API. Você pode criar seu próprio app com este fluxo de trabalho para uso pessoal. Fale conosco para servidores de alta disponibilidade quando estiver pronto para lançar para o mundo. Veja a documentação completa da API de renderização.
curl https://cloud.graydient.ai/api/v3/render/ \
  -X POST \
  -H "Content-Type: application/vnd.api+json" \
  -H "Accept: application/vnd.api+json" \
  -H "Authorization: Bearer $GRAYDIENT_TOKEN" \
  -d '{
    "prompt": "/workflow /run:animate-ltx25 /size:640x640 /length:1200 a parrot and a pirate are singing. the lyrics are about booze, pizza, generative ai, pirate, diffusion, \"making longer videos in one shot prompts is now possible\"",
    "callback_url": "https://example.com/webhook/render"
  }'
É assim que funciona nos bastidores. Isso já está configurado para você. Os parâmetros na tabela acima se conectam a esses espaços, permitindo que você mude como funciona e quais modelos são carregados. Você não precisa entender ou modificar isso - já funciona, tudo configurado.
Visão somente leitura. As pílulas destacadas são as opções que uma chamada pode definir. Prompt natural; descreva o som assim como o movimento.
Todos os fluxos de trabalho: Workflows Poderosos