
Animuj przepływ pracy LTX-2.5 obraz-na-wideo
LTX-2.5 zamienia obraz w wideo z dźwiękiem generowanym w tym samym przebiegu. Model rozumie język naturalny, więc nie są potrzebne specjalne tagi ani sztuczki, by uzyskać audio: opisz, co się dzieje i co słychać. Możliwe są dłuższe jednorazowe filmy; przykład na stronie głównej to klip 1200 klatek z jednego promptu. Ulepszacz promptu (/slot1:1) przepisuje twój prompt z większą ilością szczegółów i poprawia ogólną jakość.
Kompatybilne / Dostępne w aplikacjach zasilanych przez Graydient
Przykładowe renderingi
Wykonane modelami, które uruchamia ten workflow, udostępnione przez ich twórców na ModelTrends. Wybierz miniaturę, aby zobaczyć render w dużym rozmiarze wraz z promptem, który go stworzył.
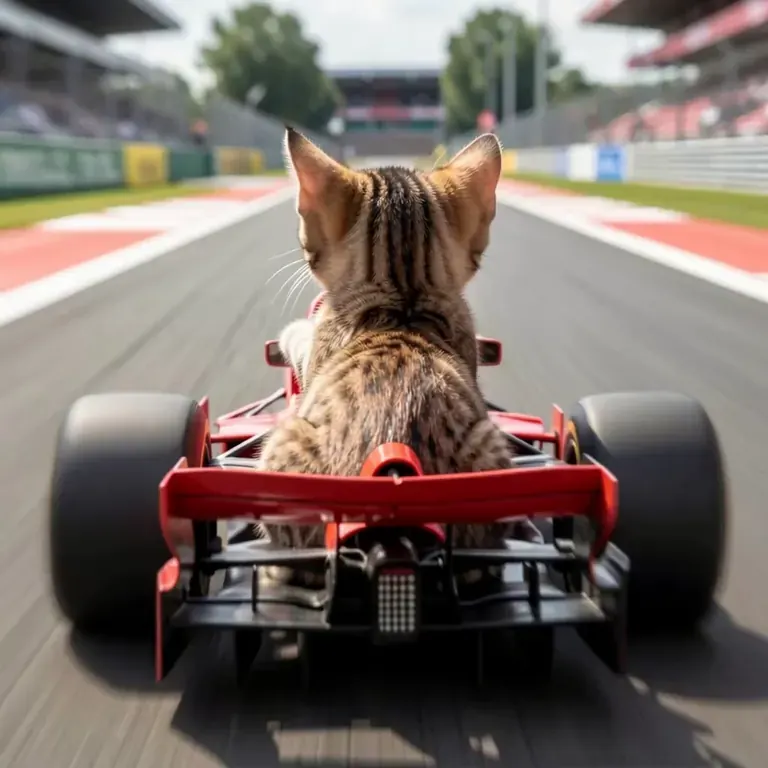
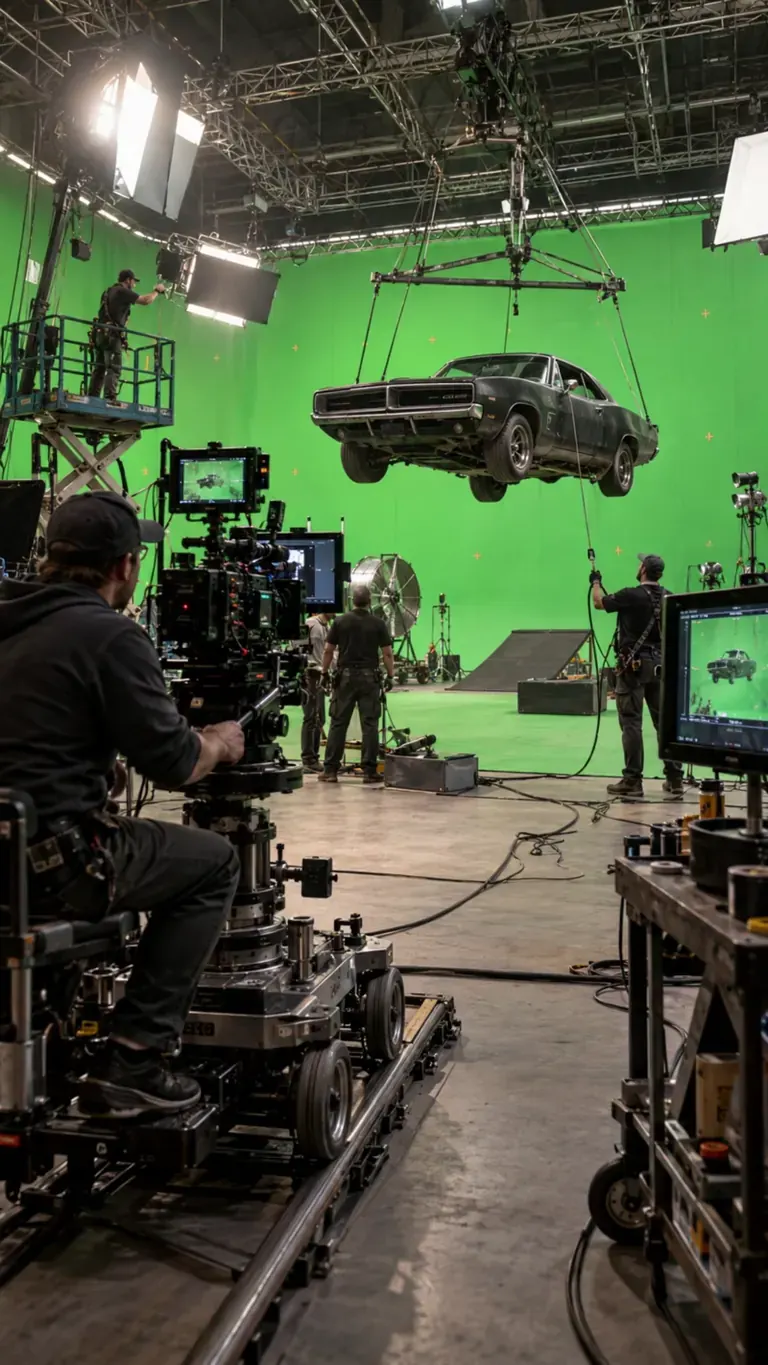
Render autorstwa Petishamiaou z (LTX-2 Lora) - Rally (Race) Driver POV Video
r4llyp0v, POV view of a kitten driving a formula1 car on a track at fast speed.
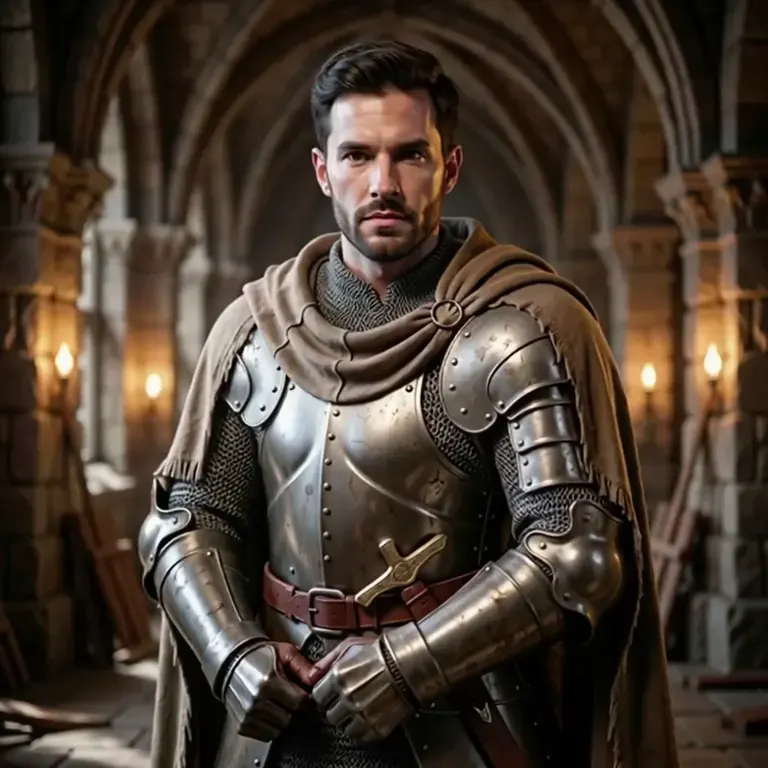
Render autorstwa kabachuha z Disguise Drop - LTX-2 / Wan2.1 14B FLF2V
Disguise drop. A knight in shining, bulky armor stands in a castle courtyard. He struggles to move, then has an idea. He unzips the chest plate, revealing not a man, but a clever miniature raccoon inside. The miniature raccoon pops out, drops the suit, and scurries off with a piece of stolen treasure.
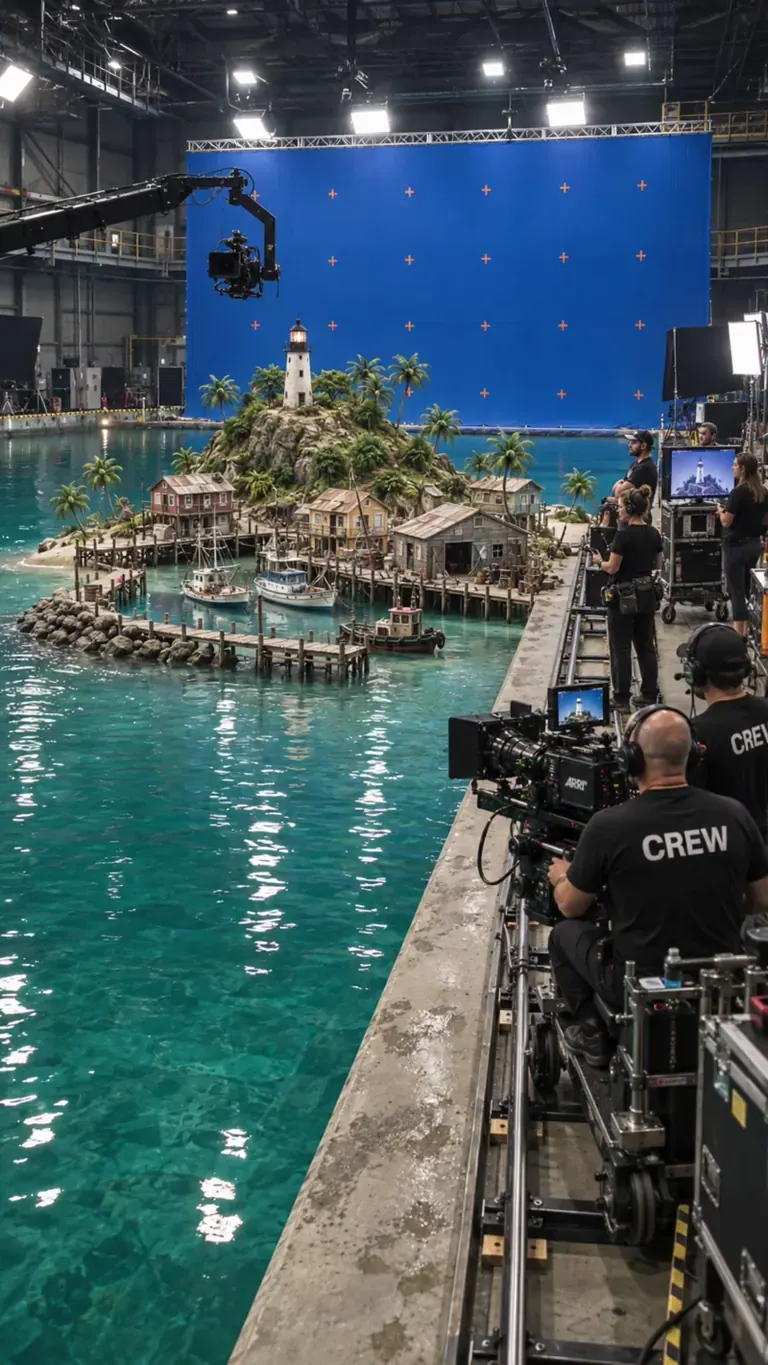
Render autorstwa Solricks z BTS Movie Set
btssetstyle, locked-off stationary camera, miniature water-tank film shoot. The off-screen director calls, "And... action!" as a wave-maker sends a realistic surge across the studio tank. The wave crashes into the miniature harbor, tossing scale boats and flooding the wooden piers with white foam. As the water dissipates into calm foam, the director calls, "Cut!" The camera crew in the foreground relaxes, smiles, and applauds the take. Realistic water physics, blue-screen soundstage, 4k photorealistic
Render autorstwa Solricks z BTS Movie Set
btssetstyle, Create a realistic behind-the-scenes vehicle stunt shoot. The suspended car moves very slightly on its rig with believable weight and inertia while crew members make natural adjustments around the set. The camera operator slowly moves the dolly along the track, technicians monitor the suspended vehicle, and the overhead rig remains stable. Keep all green-screen walls, stunt equipment, camera rigs and visible crew present throughout. Motion should be restrained, physically grounded and documentary-like, as if filmed during a real high-budget action production.
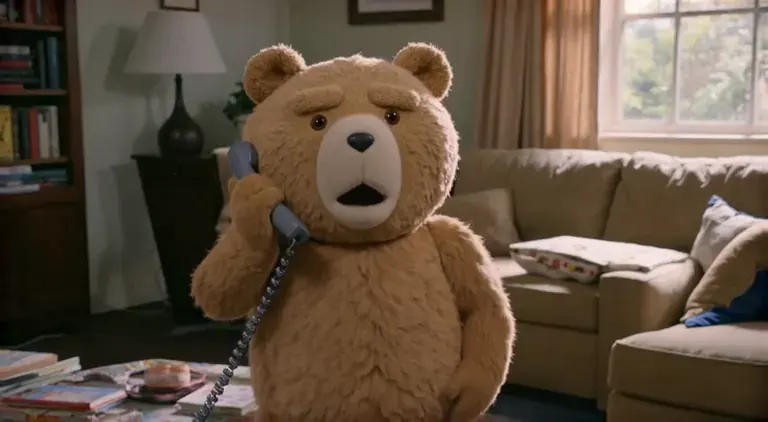
Render autorstwa kronos1959777 z Immediate Scene Transition [LTX 2.3]
closeup of Ted_Bear in his living room on the phone saying, \"oh god, Jeffrey, you're in prison!?\" immediate scene transition to the same person (Ted_Bear) inside a prison visitor room talking to an unseen figure. After the scene transition, Ted_Bear is saying, \"Oh, Jeffrey, thank god you're doing okay. Are they treating you well here? I can't imagine my good friend Jeffrey ending up in a place like this. You've always been so good to people, especially ***.
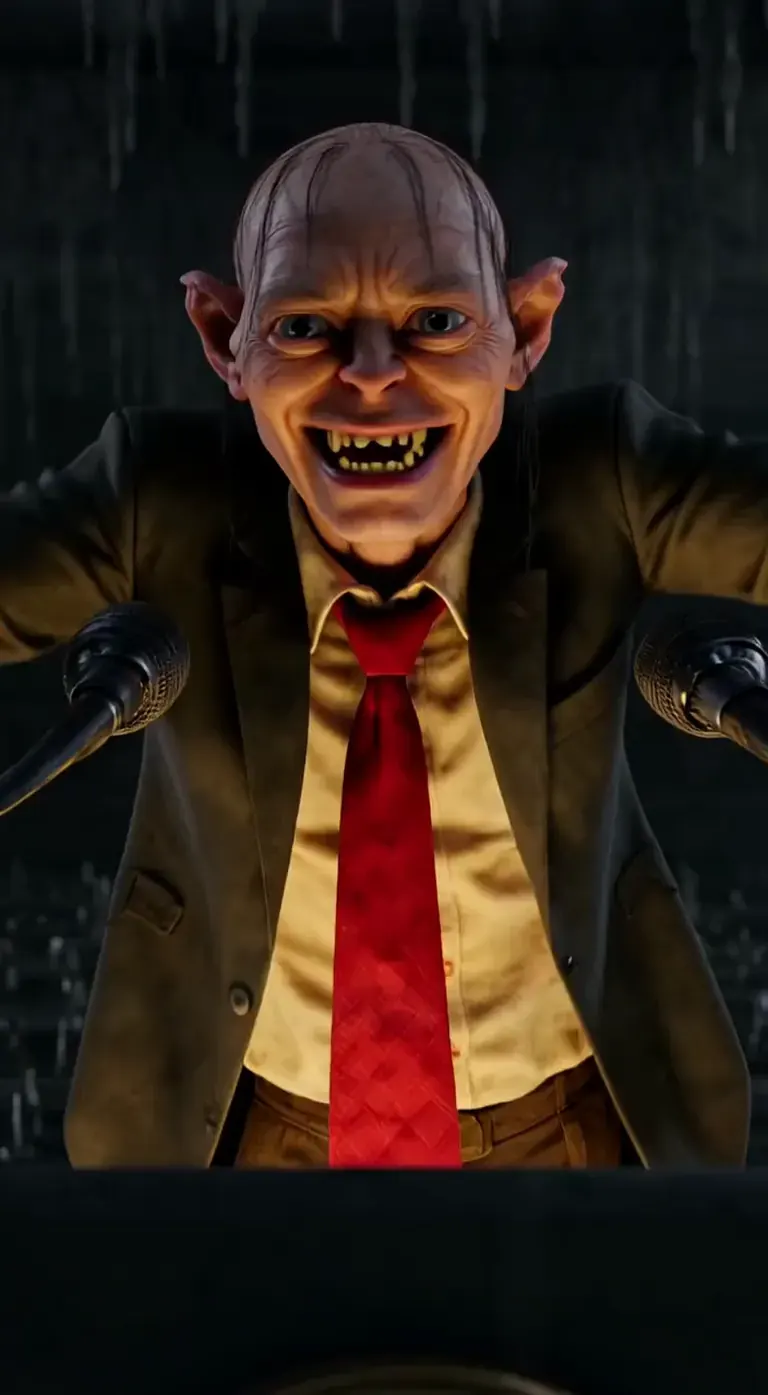
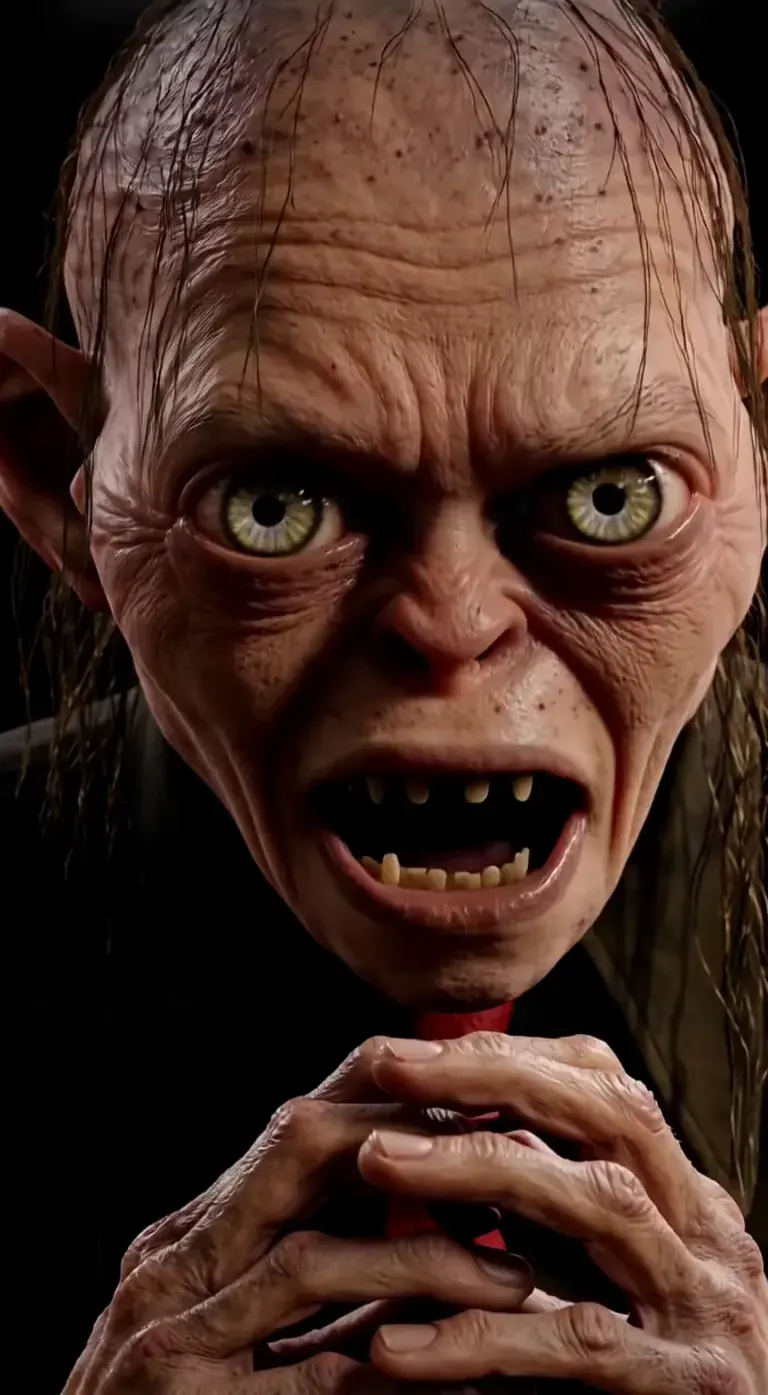
Prompt by playtime_ai_ · Gollum - LTX-2
Every time I hear trump speak, this is how I see it in my head... It really isn't fair to Gollum though. At least Gollum has redeeming qualities. Anyway, Donald Trump really said this dumb shite. Enjoy!
Render autorstwa playtime_ai_ z Gollum - LTX-2
Every time I hear trump speak, this is how I see it in my head... It really isn't fair to Gollum though. At least Gollum has redeeming qualities. Anyway, Donald Trump really said this dumb shite. Enjoy!
 Renderingi i prompt z ModelTrends, katalogu modeli AI do obrazów i wideo.
Opcje
| Opcja | Mapuje na | Domyślnie |
|---|---|---|
(image) | Load Image → image | — |
(prompt) | CLIP Text Encode → text | — |
/guidance | KSampler → cfg | 3 |
/length | LTXV Img To Video → length (frames) | 1200 |
/seed | KSampler → seed | random |
/size | LTXV Img To Video → width, height | 640 × 640 |
/slot1 | Prompt Enhancer → enhance (1 = on) | 0 |
/steps | KSampler → steps | 30 |
Używane modele
 Animate LTX-2.5
Model zaimportowany przez shortcode
/run:animate-ltx25 z ModelTrends
Zobacz na ModelTrends
Dla deweloperów (opcjonalnie)
Przykładowy fragment API. Możesz zbudować własną aplikację z tym workflow do użytku osobistego. Skontaktuj się z nami po serwery o wysokiej dostępności, gdy będziesz gotowy do wdrożenia na świat. Zobacz pełna dokumentacja API renderowania.
curl https://cloud.graydient.ai/api/v3/render/ \
  -X POST \
  -H "Content-Type: application/vnd.api+json" \
  -H "Accept: application/vnd.api+json" \
  -H "Authorization: Bearer $GRAYDIENT_TOKEN" \
  -d '{
    "prompt": "/workflow /run:animate-ltx25 /size:640x640 /length:1200 a parrot and a pirate are singing. the lyrics are about booze, pizza, generative ai, pirate, diffusion, \"making longer videos in one shot prompts is now possible\"",
    "callback_url": "https://example.com/webhook/render"
  }'
Tak to działa za kulisami. Jest to już dla Ciebie skonfigurowane. Parametry w powyższej tabeli podłączają się do tych miejsc, pozwalając Ci zmieniać sposób działania i które modele są ładowane. Nie musisz tego rozumieć ani modyfikować – po prostu działa, już ustawione.
Widok tylko do odczytu. Podświetlone pigułki to opcje, które można ustawić przy wywołaniu. Naturalne promptowanie; opisz zarówno dźwięk, jak i ruch.
Wszystkie workflowy: Potężne Workflowy