
Workflow MiniMax H3 da testo a video
MiniMax H3 trasforma un prompt in un video con il suono generato nello stesso passaggio: descrivi la scena, il movimento e ciò che si sente, e il clip torna con l’audio. È il workflow video più usato su Graydient, con una vasta libreria di stili e movimenti fine-tuned che si integrano come LoRA. Pesi aperti, ospitato e pronto all’uso; nessuna configurazione.
Compatibile / Disponibile nelle app supportate da Graydient





Render di esempio
Realizzati con i modelli che questo workflow esegue, condivisi dai loro creatori su ModelTrends. Scegli una miniatura per vedere il render ingrandito con il prompt che lo ha generato.
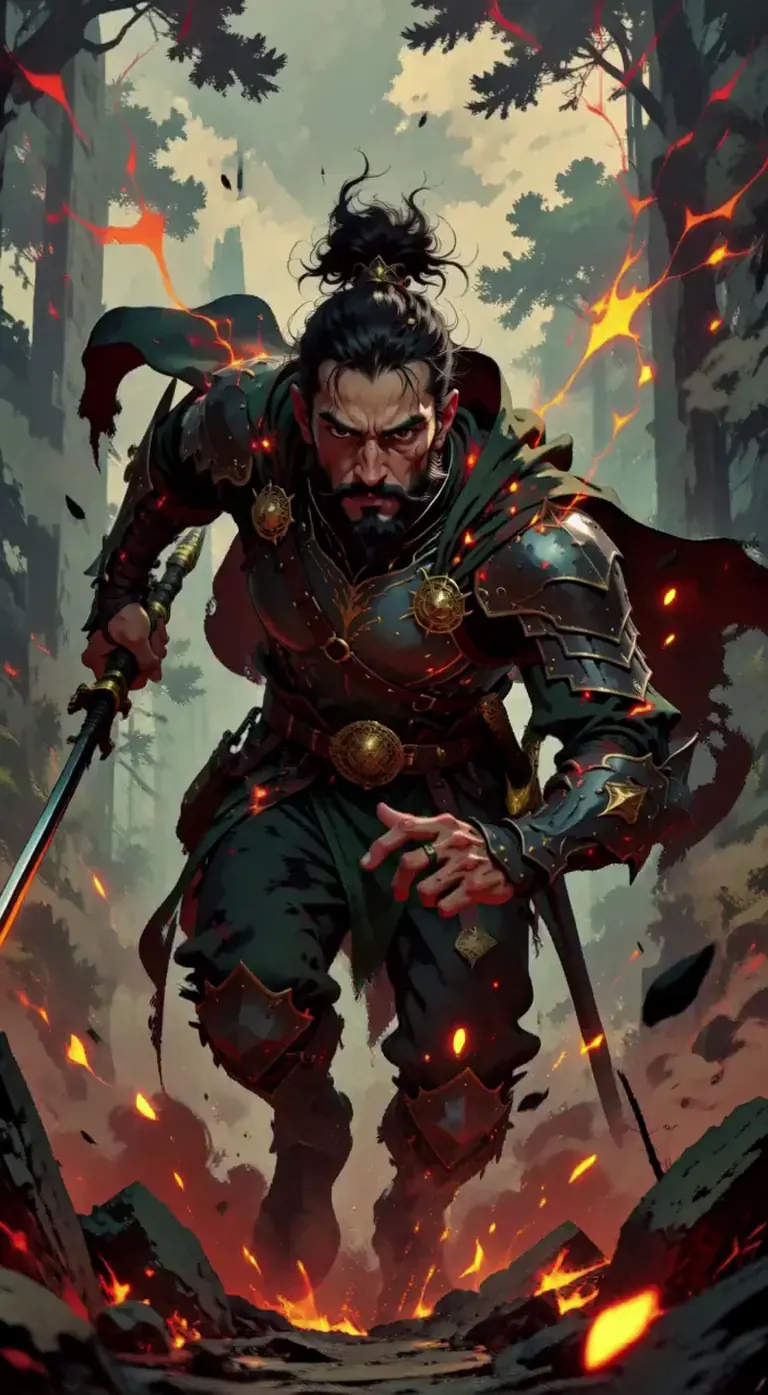


Render di Moonbear_AIArt con Grandline - Legendary Stylized Illustration
a stylized illustration of a warrior lunging forward through smoke and sparks, cloak whipping in the wind, embers trailing behind, intense forward motion, dynamic perspective, cinematic lighting
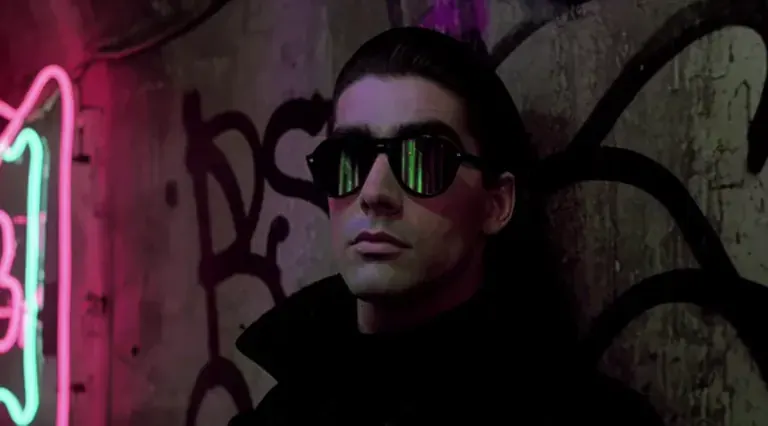
Render di FuenfFingerFaultier con Dark Cinematic Video
Cinematic close-up shot of a 30 y.o. man with mirrored sunglasses and a long black coat, leaning to the wall of a dirty neon-lit tunnel with graffiti on the wall. Looking very cool and handsome, dark hair slicked back. He looks to the viewer and takes off his sunglasses, revealing large, ridiculous googly eyes underneath. Techno dance music, flickering lights. 1980s movie, high resolution. Photorealism, 8K, soft focus, depth of field.
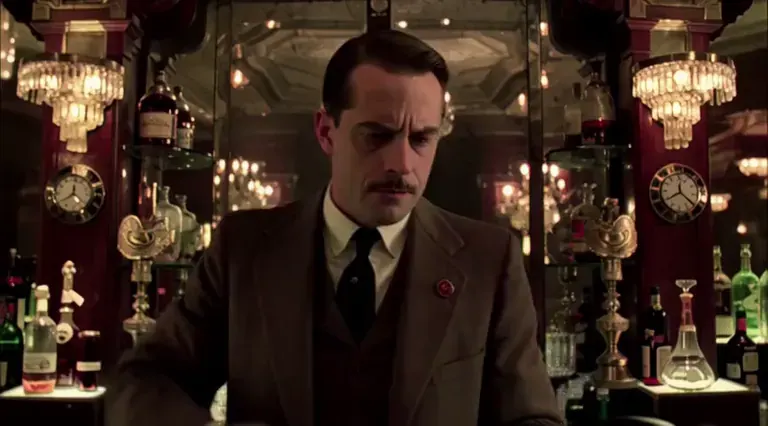
Render di FuenfFingerFaultier con Dark Cinematic Video
Cinematic medium shot of a bar keeper in a very posh, 1950s upscale bar. He picks up an old-fashioned telephone and puts it to his ear. A distorted voice on the telephone says "Is your refrigerator running?". The bar keeper answers "yes". The voice on the phone says "Then you better catch it" and bursts out laughing. The bar keeper hangs up the phone with a trembling hand. He looks into the camera angry, furrowing his brow and clenching his jaw, then cries out in anger. No music. 2020s movie, high resolution. photorealism, 8K, sharp focus
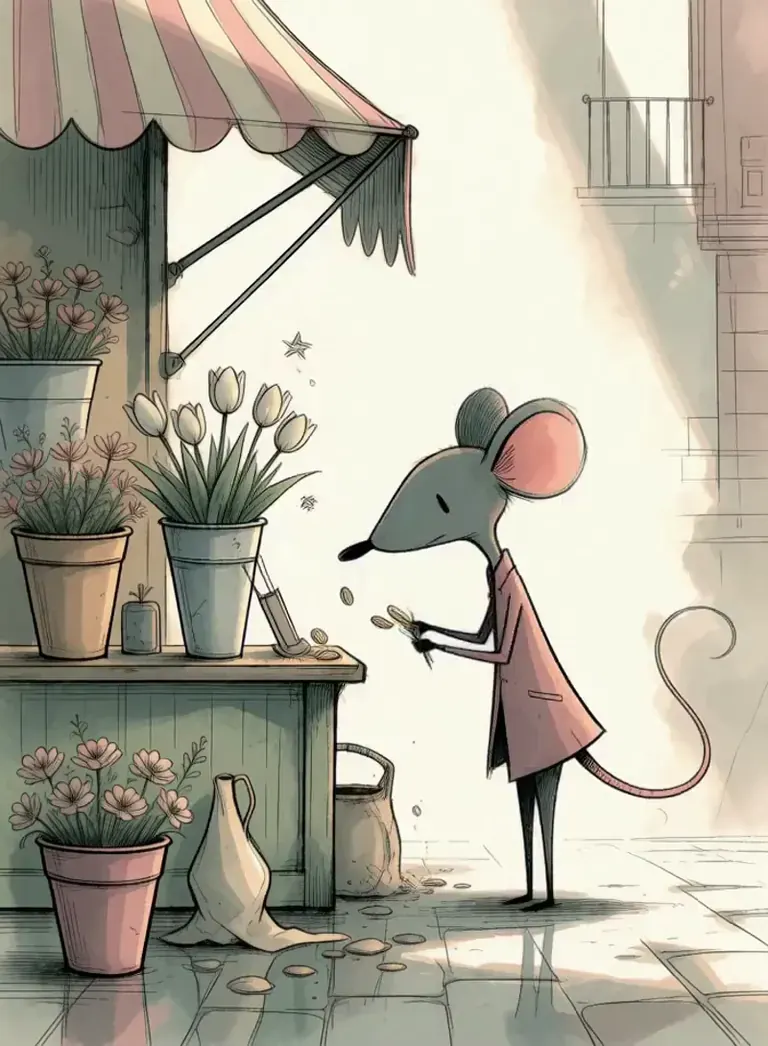
Render di liutyi2 con Strange Reverie
StrangeDaal, pink coat mouse mouse buy a 3 flowers bouquet and walk with the bouquet down the street
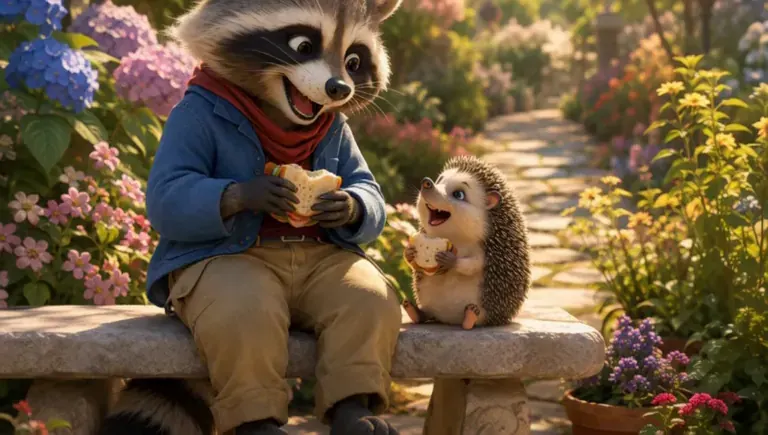
Render di Solricks con 3D Animation Style
3dsrx, a raccoon wearing a blue denim jacket and a red scarf sits on a stone bench, holding a sandwich in his left hand and a small piece of bread in his right hand. The raccoon has a friendly expression and is looking at a hedgehog sitting on the same bench. The hedgehog is holding a piece of bread in its right hand and has a happy expression. The background features a garden with colorful flowers, including purple and pink blooms, and a stone path leading into the distance. A lamppost stands in the background, and the sun is shining brightly, casting a warm glow over the entire scene.
Render di ReltivlyObjectv con Stylized PBR Animation [MiniMax H3 Ref2VA]
PBRSty1e, highly detailed cinematic video, complex crowd motion, rich environment. A bustling medieval marketplace at golden hour. Dozens of people move naturally through the frame — merchants calling out, children running, carts rolling over cobblestones. Colorful cloth canopies sway gently, hanging lanterns glow warmly, and dust floats in the low sunlight. The camera tracks slowly forward at eye level through the dense crowd, weaving between people, occasionally brushing past hanging fabrics. Strong depth, layered movement, realistic cloth and ambient life. Mood is lively, warm, and immersive.
Render di CitronLegacy con BOTW Zelda Style [Minimax H3]
b0twC1tr0n, a pointed-ear young man with tousled blond-brown hair, wearing a dark business suit with a white shirt and black tie, he puts on cool sunglasses then crosses his arms confidently and smirks, and says "deal with it" the background is a dark starry void with faint streaks of light, high-contrast dramatic lighting, stylized cel-shaded rendering, moody surreal atmosphere, camera holds a medium close-up with small amplitude at slow speed
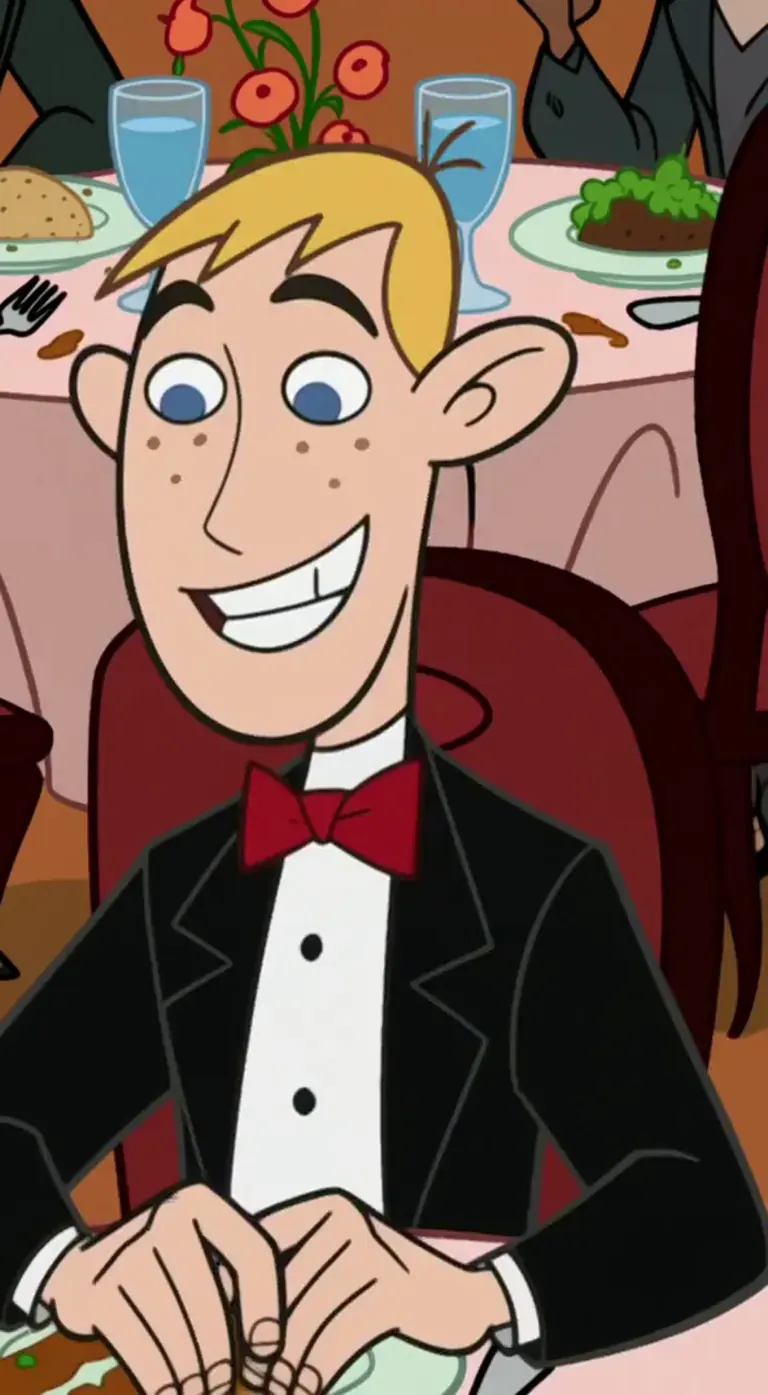
Render di CitronLegacy con Kim Possible (Series Style) [Minimax H3]
k1mC1tr0n, r0n, a freckled teenage boy with spiky blond hair seated at a restaurant table, wearing a formal black tuxedo jacket over a white collared shirt with a red bow tie, he grins broadly then says in a confident tone “Stoppable, Un-Stoppable” and smirks, warm pink and orange restaurant lighting, plates of food in the background, cel-shaded style, cheerful festive mood, camera holds a medium close-up with small amplitude at slow speed
 Render e prompt da ModelTrends, il catalogo di modelli AI per immagini e video.
Opzioni
| Opzione | Mappa a | Predefinito |
|---|---|---|
(prompt) | CLIP Text Encode → text | — |
/guidance | KSampler → cfg | 4 |
/length | Empty MiniMax Latent → length (frames) | 125 |
/seed | KSampler → seed | random |
/size | Empty MiniMax Latent → width, height | 640 × 640 |
/steps | KSampler → steps | 20 |
Modelli usati
 MiniMax H3 Video Modello importato tramite shortcode
/run:minimax-h3 da ModelTrends Vedi su ModelTrends Per sviluppatori (opzionale)
Esempio di snippet API. Puoi costruire la tua app con questo flusso di lavoro per uso personale. Passa a un piano Business quando sei pronto per il deployment. Vedi la documentazione completa dell'API di rendering.
curl https://cloud.graydient.ai/api/v3/render/ \
  -X POST \
  -H "Content-Type: application/vnd.api+json" \
  -H "Accept: application/vnd.api+json" \
  -H "Authorization: Bearer $GRAYDIENT_TOKEN" \
  -d '{
    "prompt": "/workflow /run:minimax-h3 /size:640x640 /length:125 a parrot in a pirate hat dances on the deck of a ship at sunset while a sea shanty plays",
    "callback_url": "https://example.com/webhook/render"
}'Ecco come funziona dietro le quinte. È già configurato per te. I parametri nella tabella sopra si collegano a questi slot, permettendoti di cambiare come funziona e quali modelli vengono caricati. Non devi capire o modificare questo - funziona già, tutto pronto.
Vista in sola lettura. Le pillole evidenziate sono le opzioni che una chiamata può impostare. Descrivi il suono oltre all’immagine; i fine-tune cambiano lo stile o il movimento.
Documentazione nodi su ModelTrends
Spiegazioni in linguaggio semplice per i nodi in questo grafo: cosa fa ciascuno, i suoi input e output, e come correggere gli errori che genera.
Tutti i workflow: Flussi di lavoro potenti