
Flusso di lavoro Animate LTX-2.5 da immagine a video
LTX-2.5 trasforma un'immagine in un video con il suono generato nello stesso passaggio. Il modello comprende il linguaggio naturale, quindi non servono tag o trucchi speciali per ottenere l'audio: descrivi cosa succede e cosa si sente. Sono possibili video one-shot più lunghi; l'esempio nella pagina principale è un clip di 1200 fotogrammi da un solo prompt. Il potenziatore di prompt (/slot1:1) riscrive il tuo prompt con più dettagli e migliora la qualità complessiva.
Compatibile / Disponibile nelle app supportate da Graydient
Render di esempio
Realizzati con i modelli che questo workflow esegue, condivisi dai loro creatori su ModelTrends. Scegli una miniatura per vedere il render ingrandito con il prompt che lo ha generato.
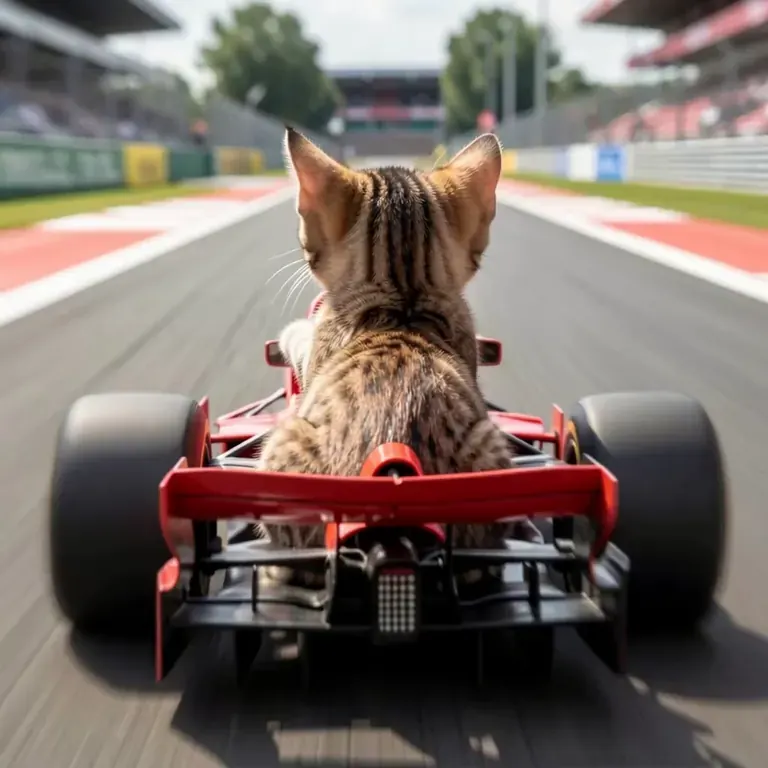
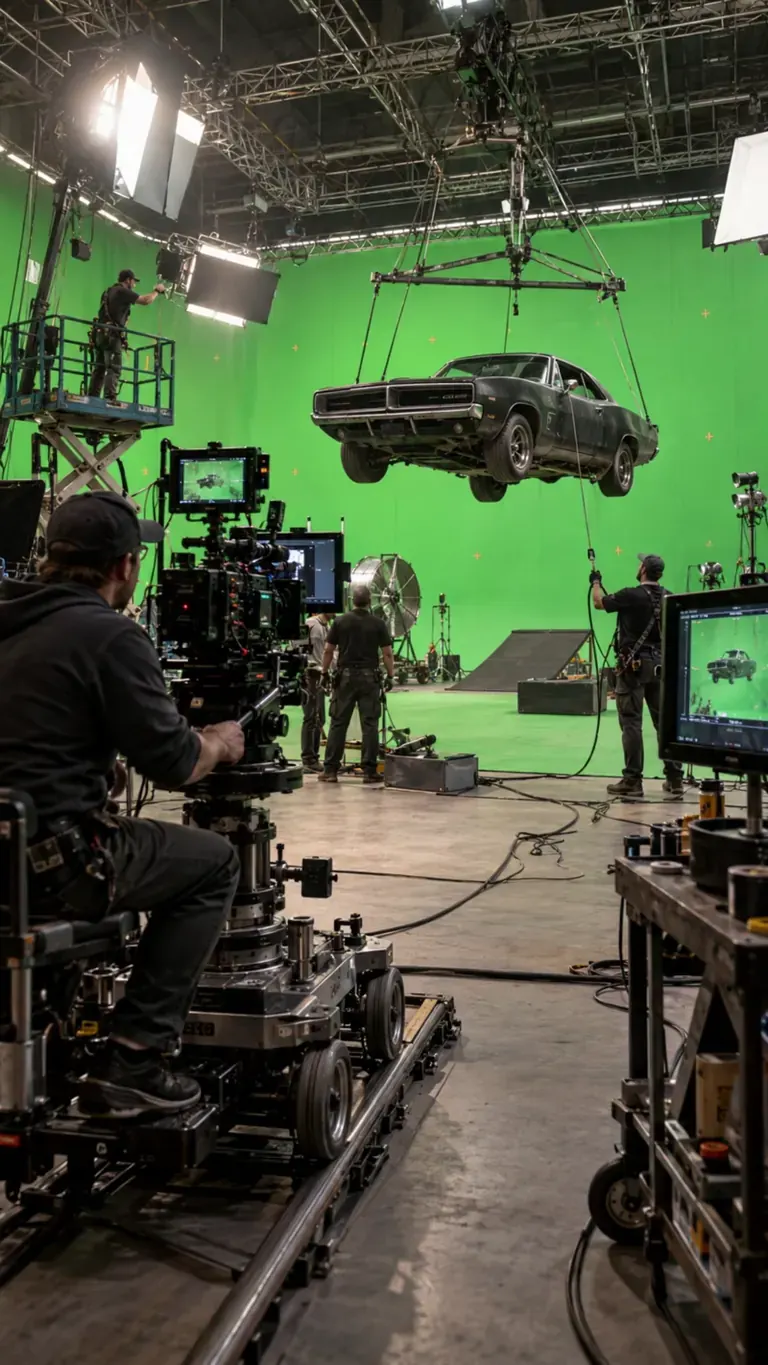
Render di Petishamiaou con (LTX-2 Lora) - Rally (Race) Driver POV Video
r4llyp0v, POV view of a kitten driving a formula1 car on a track at fast speed.
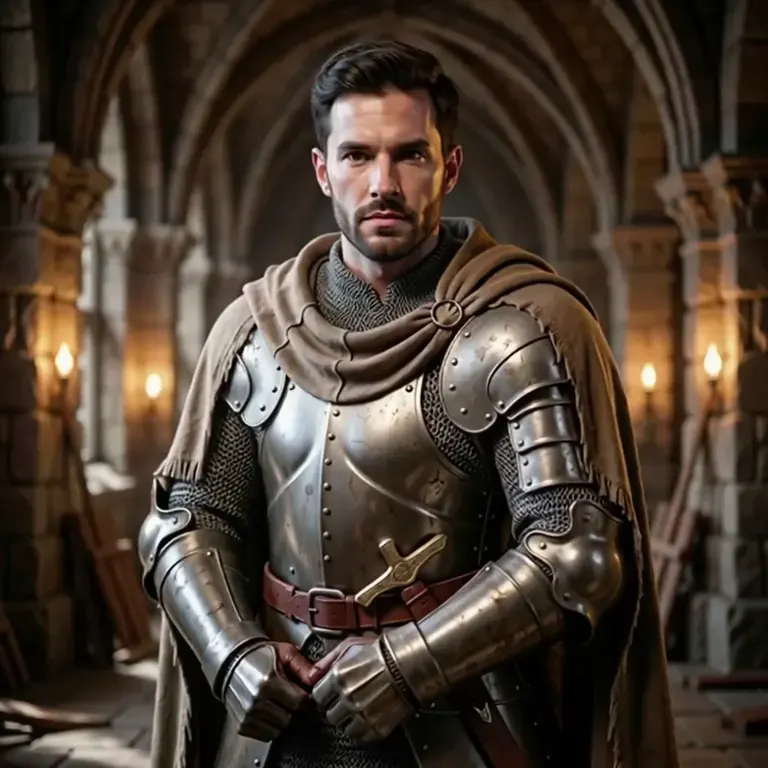
Render di kabachuha con Disguise Drop - LTX-2 / Wan2.1 14B FLF2V
Disguise drop. A knight in shining, bulky armor stands in a castle courtyard. He struggles to move, then has an idea. He unzips the chest plate, revealing not a man, but a clever miniature raccoon inside. The miniature raccoon pops out, drops the suit, and scurries off with a piece of stolen treasure.
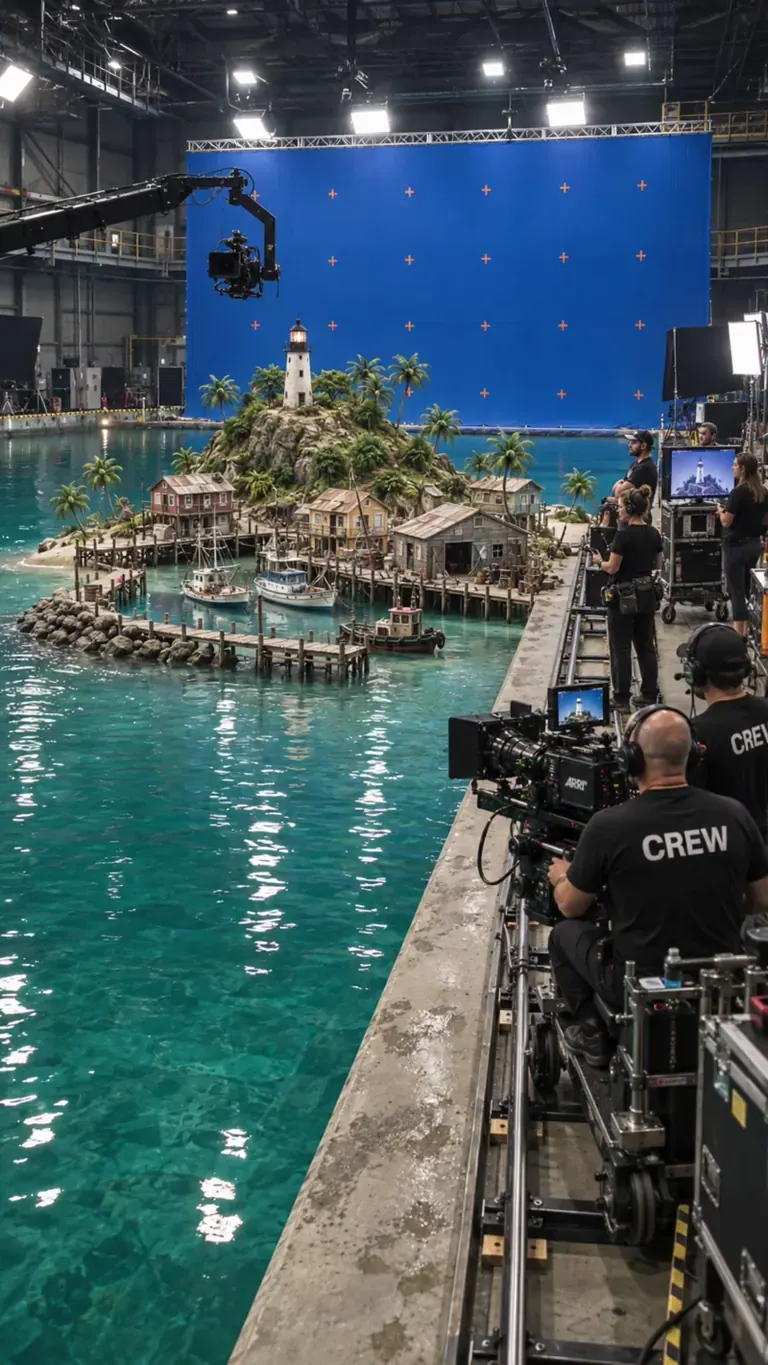
Render di Solricks con BTS Movie Set
btssetstyle, locked-off stationary camera, miniature water-tank film shoot. The off-screen director calls, "And... action!" as a wave-maker sends a realistic surge across the studio tank. The wave crashes into the miniature harbor, tossing scale boats and flooding the wooden piers with white foam. As the water dissipates into calm foam, the director calls, "Cut!" The camera crew in the foreground relaxes, smiles, and applauds the take. Realistic water physics, blue-screen soundstage, 4k photorealistic
Render di Solricks con BTS Movie Set
btssetstyle, Create a realistic behind-the-scenes vehicle stunt shoot. The suspended car moves very slightly on its rig with believable weight and inertia while crew members make natural adjustments around the set. The camera operator slowly moves the dolly along the track, technicians monitor the suspended vehicle, and the overhead rig remains stable. Keep all green-screen walls, stunt equipment, camera rigs and visible crew present throughout. Motion should be restrained, physically grounded and documentary-like, as if filmed during a real high-budget action production.
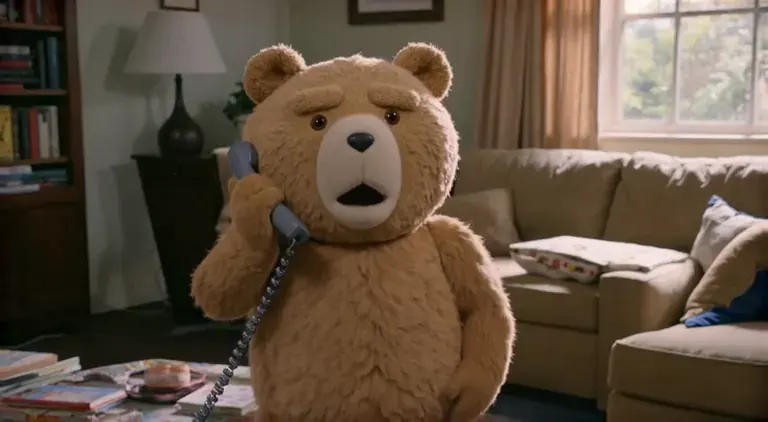
Render di kronos1959777 con Immediate Scene Transition [LTX 2.3]
closeup of Ted_Bear in his living room on the phone saying, \"oh god, Jeffrey, you're in prison!?\" immediate scene transition to the same person (Ted_Bear) inside a prison visitor room talking to an unseen figure. After the scene transition, Ted_Bear is saying, \"Oh, Jeffrey, thank god you're doing okay. Are they treating you well here? I can't imagine my good friend Jeffrey ending up in a place like this. You've always been so good to people, especially ***.
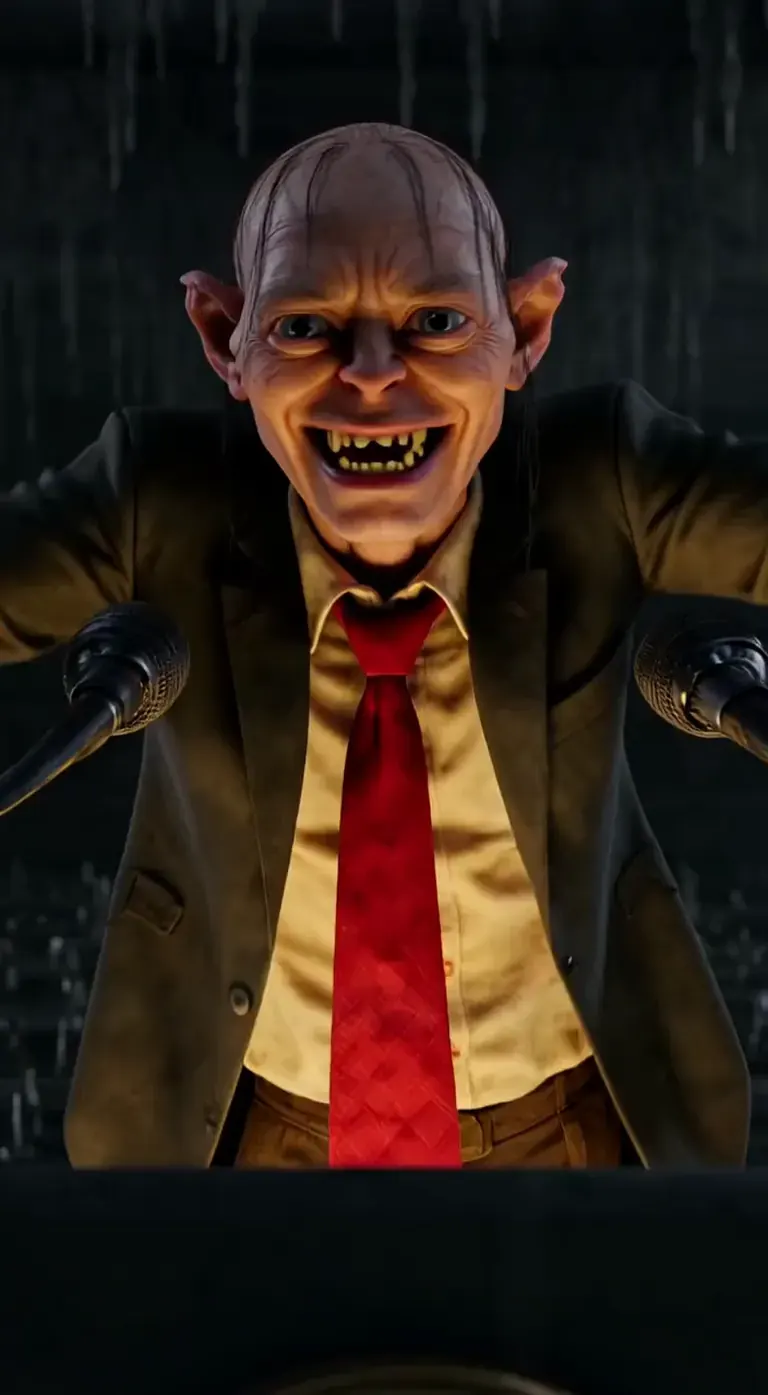
Prompt by playtime_ai_ · Gollum - LTX-2
Every time I hear trump speak, this is how I see it in my head... It really isn't fair to Gollum though. At least Gollum has redeeming qualities. Anyway, Donald Trump really said this dumb shite. Enjoy!
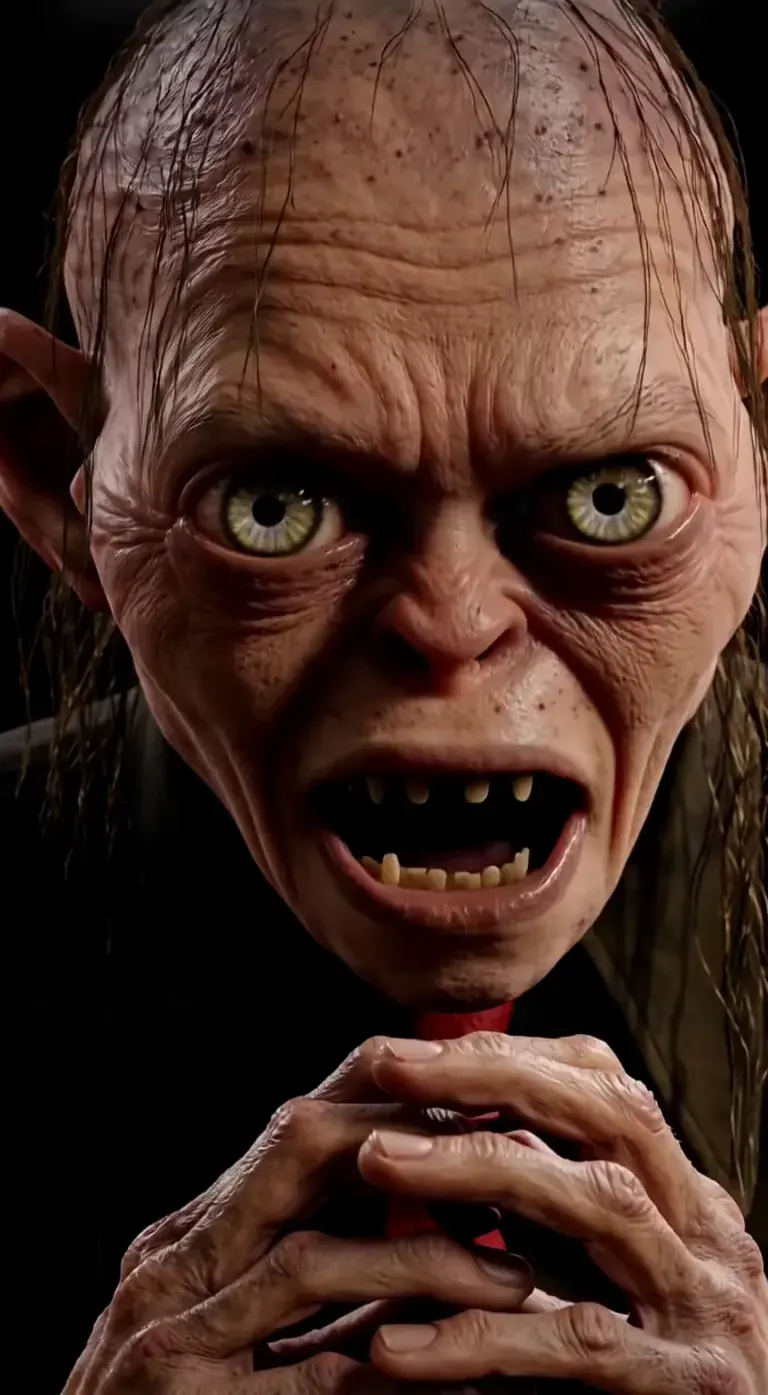
Render di playtime_ai_ con Gollum - LTX-2
Every time I hear trump speak, this is how I see it in my head... It really isn't fair to Gollum though. At least Gollum has redeeming qualities. Anyway, Donald Trump really said this dumb shite. Enjoy!
 Render e prompt da ModelTrends, il catalogo di modelli AI per immagini e video.
Opzioni
| Opzione | Mappa a | Predefinito |
|---|---|---|
(image) | Load Image → image | — |
(prompt) | CLIP Text Encode → text | — |
/guidance | KSampler → cfg | 3 |
/length | LTXV Img To Video → length (frames) | 1200 |
/seed | KSampler → seed | random |
/size | LTXV Img To Video → width, height | 640 × 640 |
/slot1 | Prompt Enhancer → enhance (1 = on) | 0 |
/steps | KSampler → steps | 30 |
Modelli usati
 Animate LTX-2.5
Modello importato tramite shortcode
/run:animate-ltx25 da ModelTrends
Vedi su ModelTrends
Per sviluppatori (opzionale)
Esempio di snippet API. Puoi creare la tua app con questo workflow per uso personale. Contattaci per server ad alta disponibilità quando sei pronto a distribuire al mondo. Vedi la documentazione completa dell'API di rendering.
curl https://cloud.graydient.ai/api/v3/render/ \
  -X POST \
  -H "Content-Type: application/vnd.api+json" \
  -H "Accept: application/vnd.api+json" \
  -H "Authorization: Bearer $GRAYDIENT_TOKEN" \
  -d '{
    "prompt": "/workflow /run:animate-ltx25 /size:640x640 /length:1200 a parrot and a pirate are singing. the lyrics are about booze, pizza, generative ai, pirate, diffusion, \"making longer videos in one shot prompts is now possible\"",
    "callback_url": "https://example.com/webhook/render"
  }'
Ecco come funziona dietro le quinte. È già configurato per te. I parametri nella tabella sopra si collegano a questi slot, permettendoti di cambiare come funziona e quali modelli vengono caricati. Non devi capire o modificare questo - funziona già, tutto pronto.
Vista in sola lettura. Le pillole evidenziate sono le opzioni che una chiamata può impostare. Prompt naturale; descrivi sia il suono che il movimento.
Tutti i workflow: Flussi di lavoro potenti