
Animate LTX-2.5 تصویر سے ویڈیو ورک فلو
LTX-2.5 ایک تصویر کو ویڈیو میں تبدیل کرتا ہے جس کی آواز ایک ہی عمل میں تیار ہوتی ہے۔ ماڈل قدرتی زبان کو سمجھتا ہے، اس لیے آڈیو حاصل کرنے کے لیے خاص ٹیگز یا چالاکیاں ضروری نہیں: جو ہوتا ہے اور جو سنا جاتا ہے اسے بیان کریں۔ لمبے ایک شاٹ ویڈیوز ممکن ہیں؛ ہوم پیج پر دیا گیا مثال ایک 1200 فریم کا کلپ ہے جو ایک پرامپٹ سے بنایا گیا ہے۔ پرامپٹ اینہینسر (/slot1:1) آپ کے پرامپٹ کو مزید تفصیل کے ساتھ دوبارہ لکھتا ہے اور مجموعی معیار کو بہتر بناتا ہے۔
Graydient سے چلنے والی ایپس میں مطابقت رکھتا / دستیاب
نمونہ رینڈر
ماڈلز کے ساتھ بنائے گئے جو یہ ورک فلو چلتا ہے، جنہیں ان کے تخلیق کاروں نے ModelTrends پر شیئر کیا ہے۔ رینڈر کو بڑا دیکھنے کے لیے تھمب نیل منتخب کریں اور وہ پرامپٹ جو اسے بنایا۔
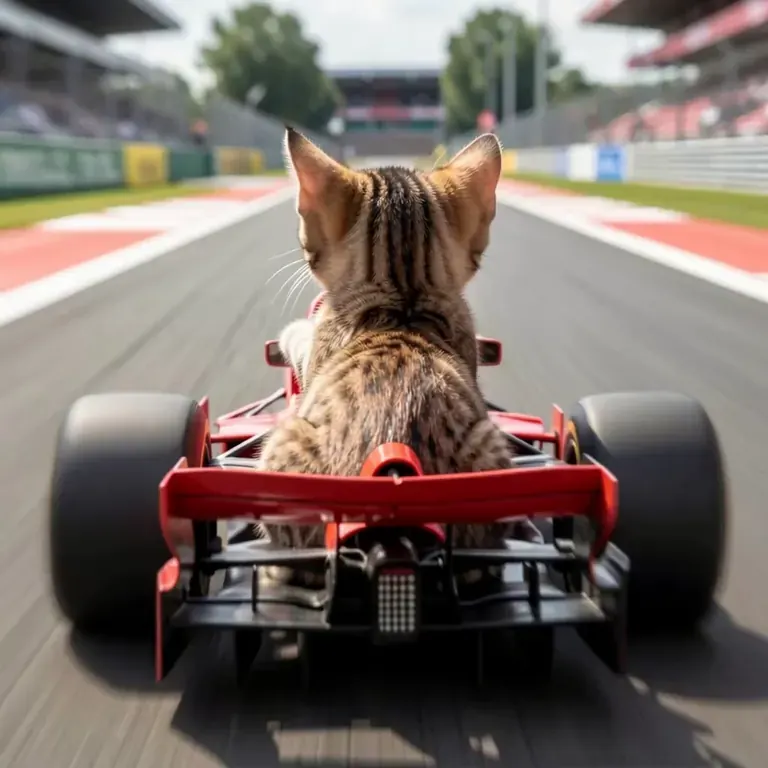
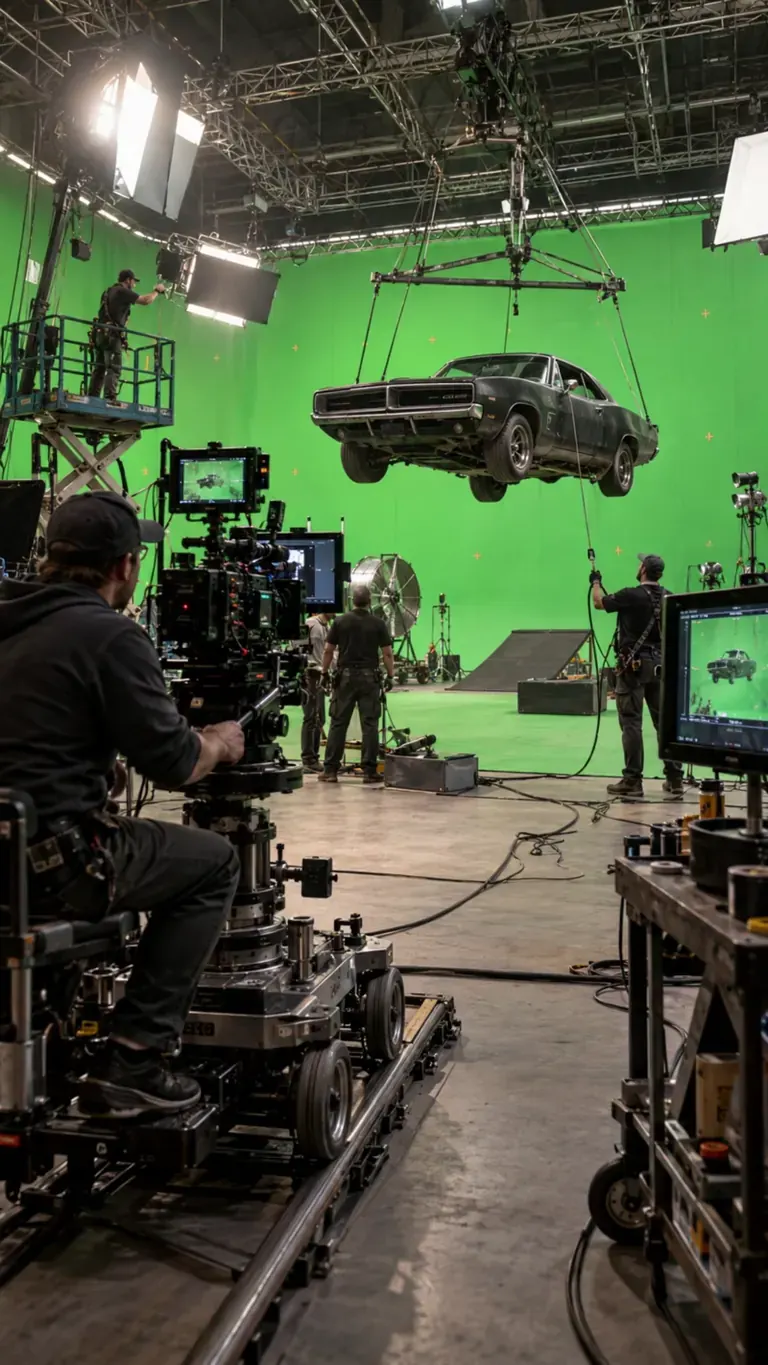
رینڈر Petishamiaou کی طرف سے (LTX-2 Lora) - Rally (Race) Driver POV Video کے ساتھ
r4llyp0v, POV view of a kitten driving a formula1 car on a track at fast speed.
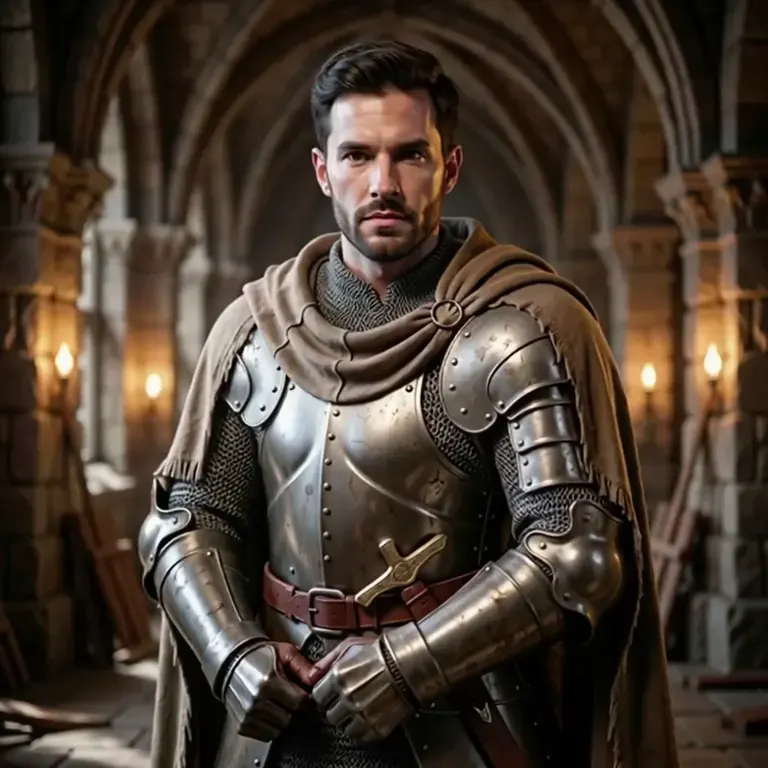
رینڈر kabachuha کی طرف سے Disguise Drop - LTX-2 / Wan2.1 14B FLF2V کے ساتھ
Disguise drop. A knight in shining, bulky armor stands in a castle courtyard. He struggles to move, then has an idea. He unzips the chest plate, revealing not a man, but a clever miniature raccoon inside. The miniature raccoon pops out, drops the suit, and scurries off with a piece of stolen treasure.
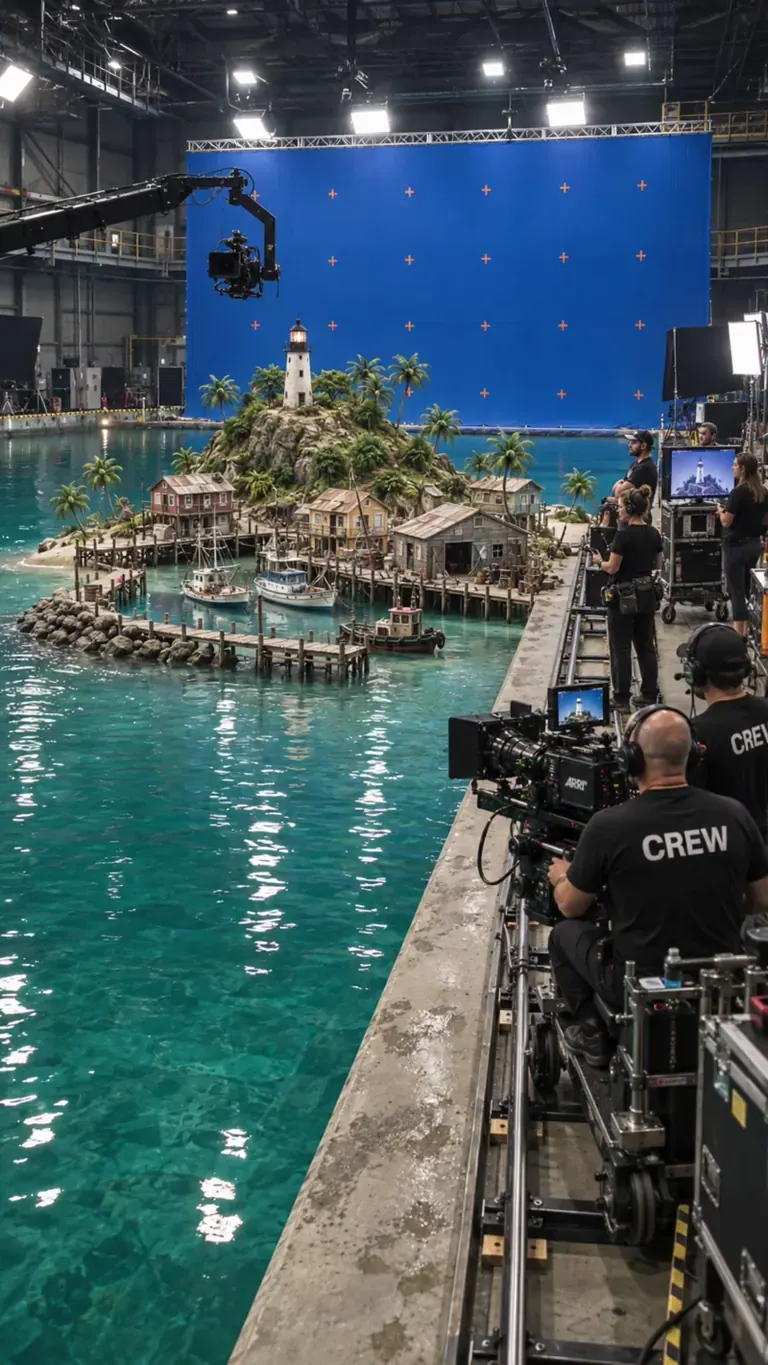
رینڈر Solricks کی طرف سے BTS Movie Set کے ساتھ
btssetstyle, locked-off stationary camera, miniature water-tank film shoot. The off-screen director calls, "And... action!" as a wave-maker sends a realistic surge across the studio tank. The wave crashes into the miniature harbor, tossing scale boats and flooding the wooden piers with white foam. As the water dissipates into calm foam, the director calls, "Cut!" The camera crew in the foreground relaxes, smiles, and applauds the take. Realistic water physics, blue-screen soundstage, 4k photorealistic
رینڈر Solricks کی طرف سے BTS Movie Set کے ساتھ
btssetstyle, Create a realistic behind-the-scenes vehicle stunt shoot. The suspended car moves very slightly on its rig with believable weight and inertia while crew members make natural adjustments around the set. The camera operator slowly moves the dolly along the track, technicians monitor the suspended vehicle, and the overhead rig remains stable. Keep all green-screen walls, stunt equipment, camera rigs and visible crew present throughout. Motion should be restrained, physically grounded and documentary-like, as if filmed during a real high-budget action production.
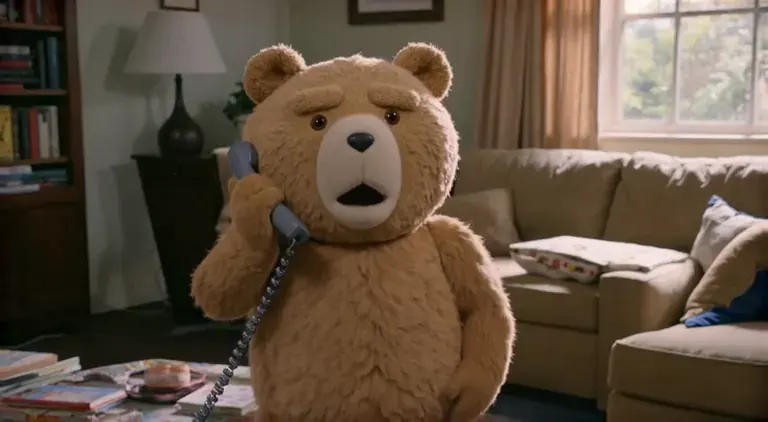
رینڈر kronos1959777 کی طرف سے Immediate Scene Transition [LTX 2.3] کے ساتھ
closeup of Ted_Bear in his living room on the phone saying, \"oh god, Jeffrey, you're in prison!?\" immediate scene transition to the same person (Ted_Bear) inside a prison visitor room talking to an unseen figure. After the scene transition, Ted_Bear is saying, \"Oh, Jeffrey, thank god you're doing okay. Are they treating you well here? I can't imagine my good friend Jeffrey ending up in a place like this. You've always been so good to people, especially ***.
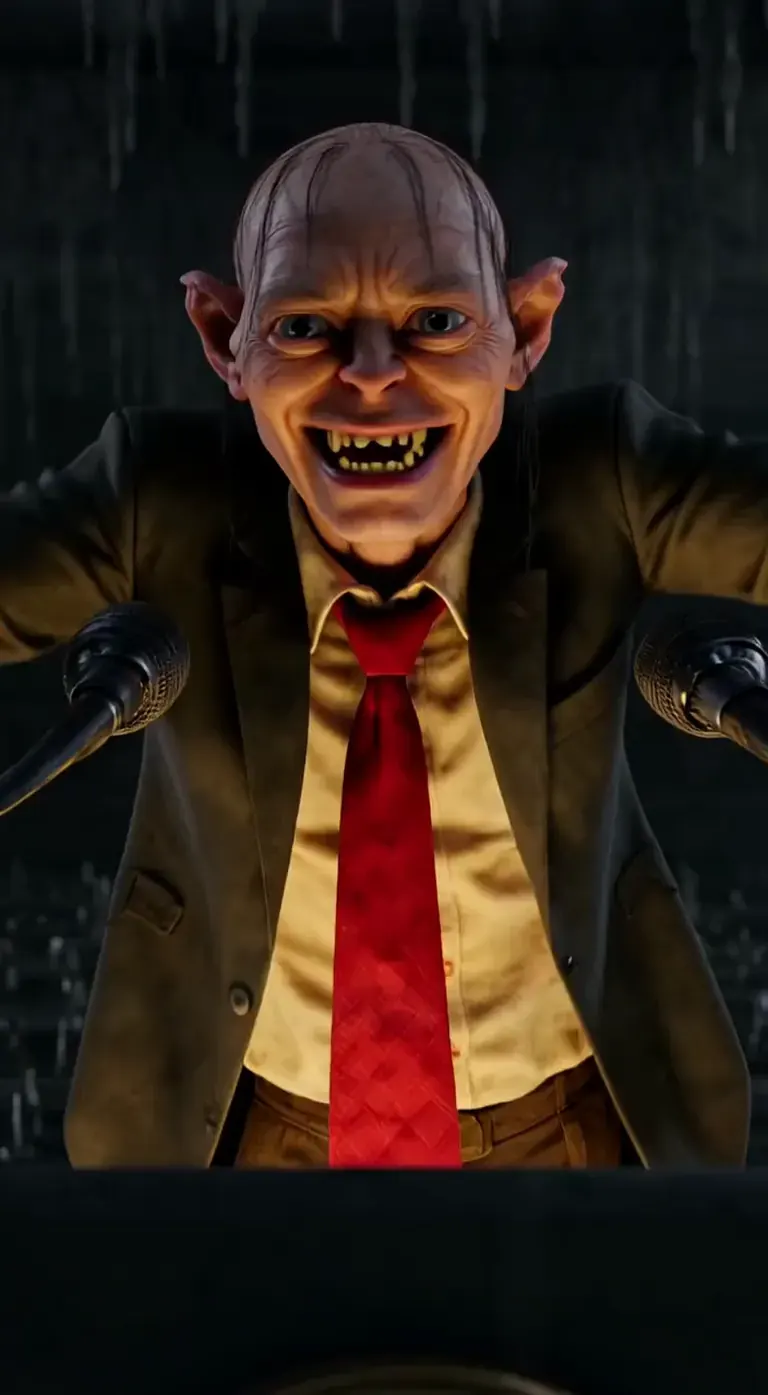
Prompt by playtime_ai_ · Gollum - LTX-2
Every time I hear trump speak, this is how I see it in my head... It really isn't fair to Gollum though. At least Gollum has redeeming qualities. Anyway, Donald Trump really said this dumb shite. Enjoy!
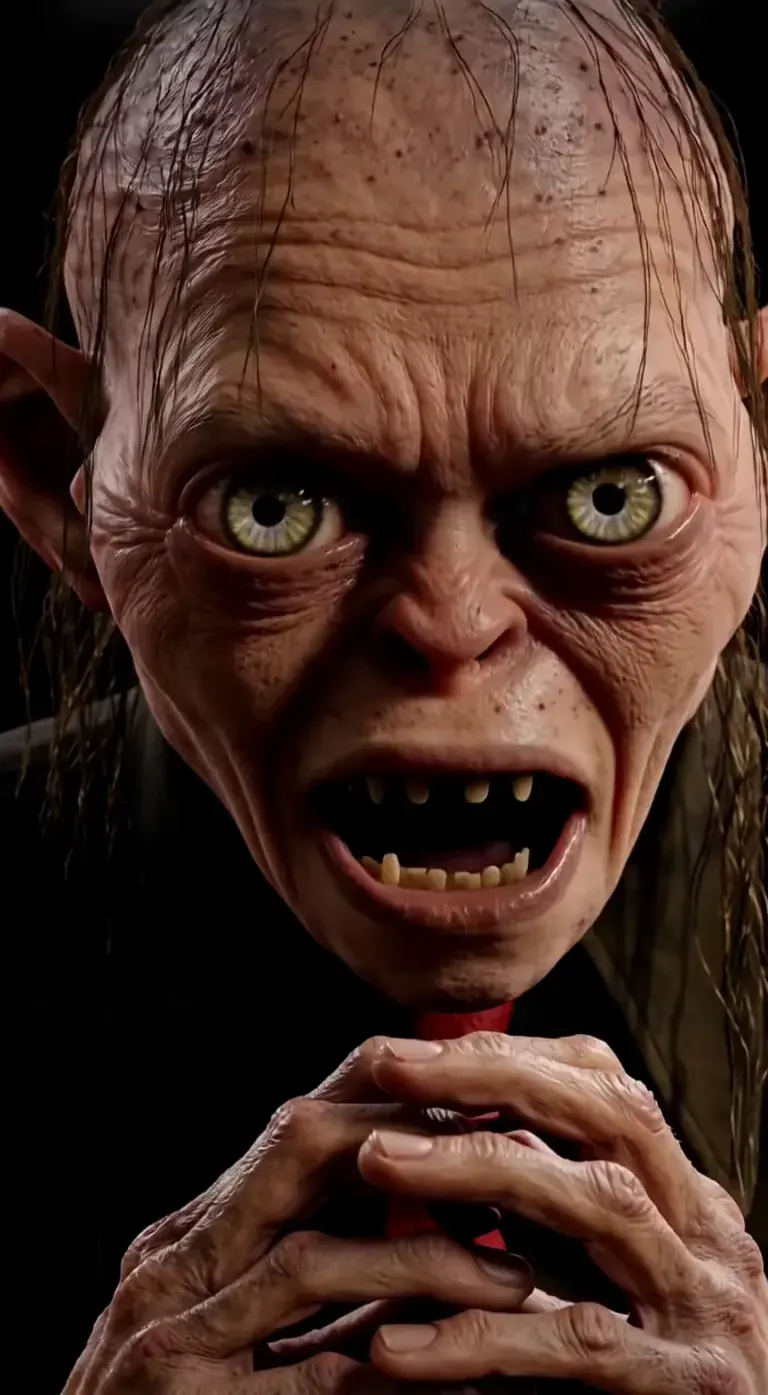
رینڈر playtime_ai_ کی طرف سے Gollum - LTX-2 کے ساتھ
Every time I hear trump speak, this is how I see it in my head... It really isn't fair to Gollum though. At least Gollum has redeeming qualities. Anyway, Donald Trump really said this dumb shite. Enjoy!
 رینڈر اور پرامپٹس ModelTrends سے، AI تصویر اور ویڈیو ماڈلز کا کیٹلاگ۔
آپشنز
| آپشن | میپ ہوتا ہے | ڈیفالٹ |
|---|---|---|
(image) | Load Image → image | — |
(prompt) | CLIP Text Encode → text | — |
/guidance | KSampler → cfg | 3 |
/length | LTXV Img To Video → length (frames) | 1200 |
/seed | KSampler → seed | random |
/size | LTXV Img To Video → width, height | 640 × 640 |
/slot1 | Prompt Enhancer → enhance (1 = on) | 0 |
/steps | KSampler → steps | 30 |
استعمال شدہ ماڈلز
 Animate LTX-2.5
ماڈل کو شارٹ کوڈ
/run:animate-ltx25 کے ذریعے ModelTrends سے درآمد کیا گیا
ModelTrends پر دیکھیں
ڈویلپرز کے لیے (اختیاری)
مثال API کوڈ کا ٹکڑا۔ آپ اس ورک فلو کے ساتھ اپنی ذاتی استعمال کے لیے اپنی ایپ بنا سکتے ہیں۔ جب آپ دنیا بھر میں تعینات کرنے کے لیے تیار ہوں تو ہم سے رابطہ کریں سے رابطہ کریں ہائی ایویلیبیلٹی سرورز کے لیے۔ دیکھیں مکمل رینڈرنگ API دستاویزات۔
curl https://cloud.graydient.ai/api/v3/render/ \
  -X POST \
  -H "Content-Type: application/vnd.api+json" \
  -H "Accept: application/vnd.api+json" \
  -H "Authorization: Bearer $GRAYDIENT_TOKEN" \
  -d '{
    "prompt": "/workflow /run:animate-ltx25 /size:640x640 /length:1200 a parrot and a pirate are singing. the lyrics are about booze, pizza, generative ai, pirate, diffusion, \"making longer videos in one shot prompts is now possible\"",
    "callback_url": "https://example.com/webhook/render"
  }'
یہ پس منظر میں کیسے کام کرتا ہے۔ یہ پہلے ہی آپ کے لیے ترتیب دیا گیا ہے۔ اوپر دی گئی جدول میں موجود پیرامیٹرز ان جگہوں میں لگتے ہیں، جو آپ کو یہ تبدیل کرنے کی اجازت دیتے ہیں کہ یہ کیسے کام کرے اور کون سے ماڈلز لوڈ ہوں۔ آپ کو اسے سمجھنے یا تبدیل کرنے کی ضرورت نہیں - یہ بس کام کرتا ہے، پہلے سے سیٹ ہے۔
صرف پڑھنے کے لیے ویو۔ نمایاں کردہ پِل وہ آپشنز ہیں جو کال سیٹ کر سکتی ہے۔ قدرتی پرامپٹنگ؛ آواز کے ساتھ ساتھ حرکت کو بھی بیان کریں۔
تمام ورک فلو: طاقتور ورک فلو