
LTX-2.5 resimden videoya iş akışını canlandır
LTX-2.5, bir resmi aynı geçişte oluşturulan sesiyle birlikte videoya dönüştürür. Model doğal dili anlar, bu yüzden ses almak için özel etiketler veya hileler gerekmez: ne olduğunu ve ne duyulduğunu tanımla. Daha uzun tek seferlik videolar mümkündür; ana sayfadaki örnek, tek bir istemden 1200 karelik bir kliptir. İstem geliştirici (/slot1:1) istemini daha ayrıntılı yazar ve genel kaliteyi artırır.
Graydient destekli Uygulamalarda Uyumludur / Mevcuttur
Örnek renderlar
Bu iş akışının çalıştırdığı modellerle yapıldı, ModelTrends'te yaratıcıları tarafından paylaşıldı. Renderı büyük görmek ve onu yapan promptu görmek için bir küçük resim seç.
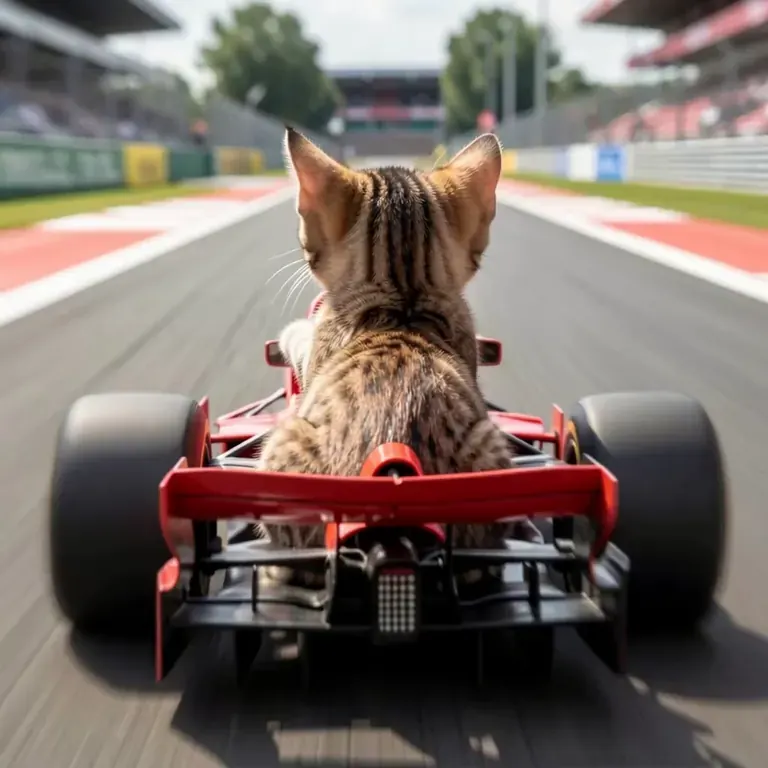
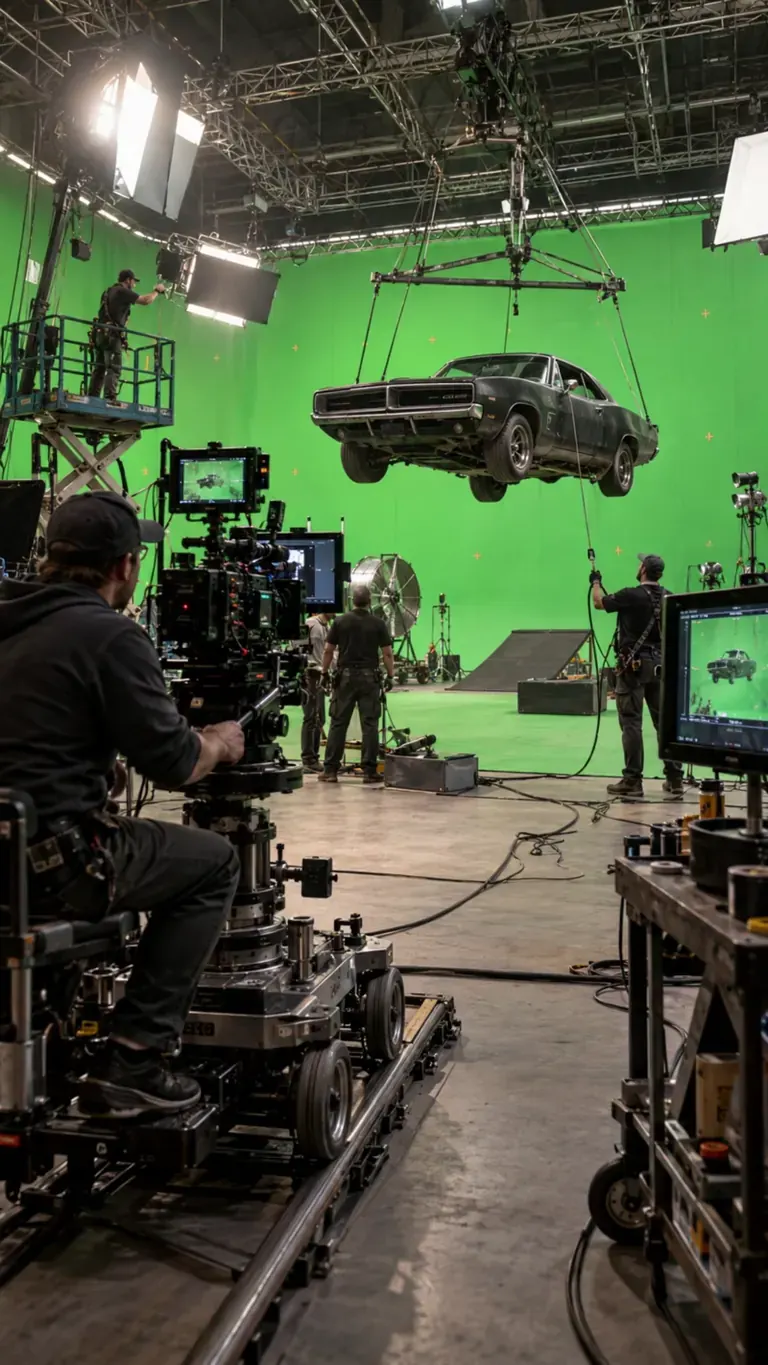
Petishamiaou tarafından (LTX-2 Lora) - Rally (Race) Driver POV Video ile render
r4llyp0v, POV view of a kitten driving a formula1 car on a track at fast speed.
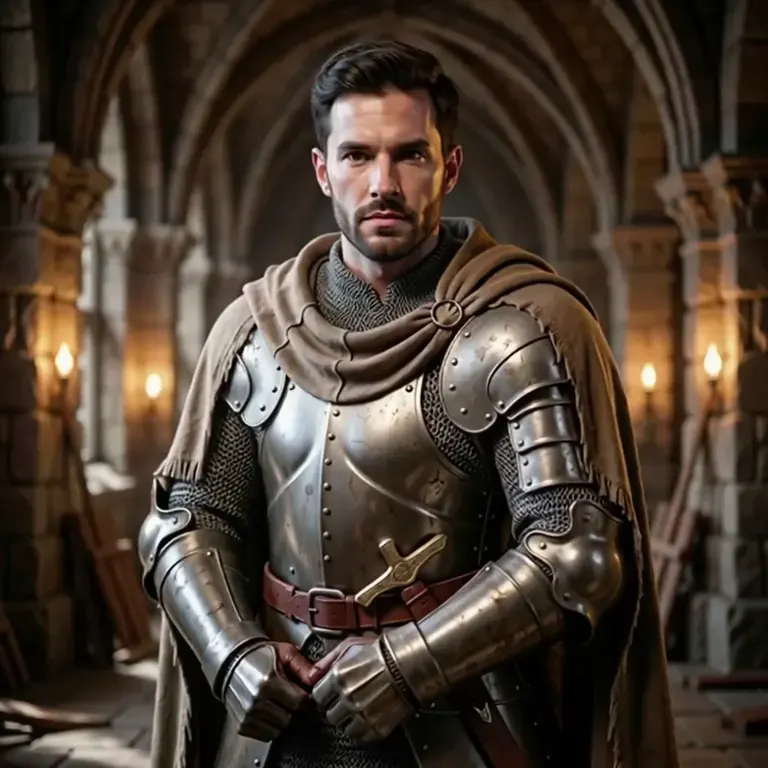
kabachuha tarafından Disguise Drop - LTX-2 / Wan2.1 14B FLF2V ile render
Disguise drop. A knight in shining, bulky armor stands in a castle courtyard. He struggles to move, then has an idea. He unzips the chest plate, revealing not a man, but a clever miniature raccoon inside. The miniature raccoon pops out, drops the suit, and scurries off with a piece of stolen treasure.
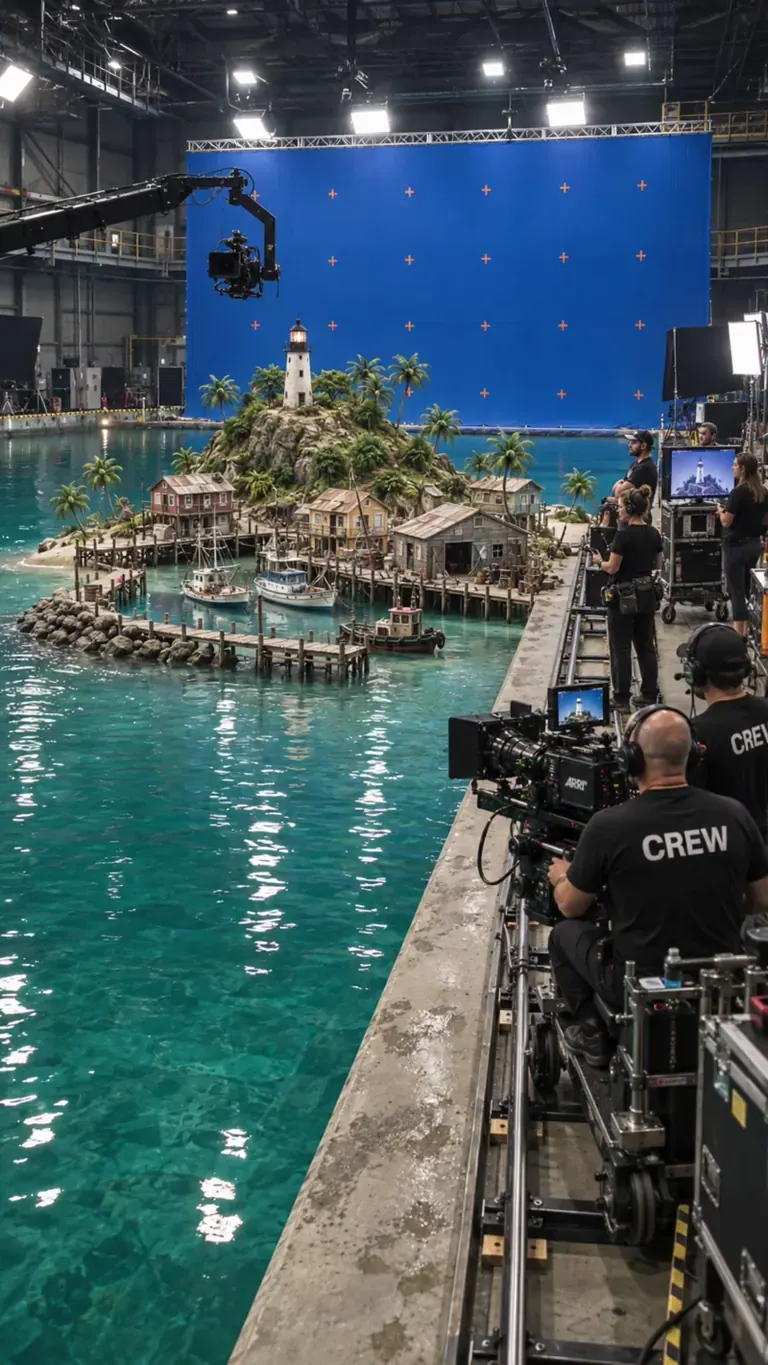
Solricks tarafından BTS Movie Set ile render
btssetstyle, locked-off stationary camera, miniature water-tank film shoot. The off-screen director calls, "And... action!" as a wave-maker sends a realistic surge across the studio tank. The wave crashes into the miniature harbor, tossing scale boats and flooding the wooden piers with white foam. As the water dissipates into calm foam, the director calls, "Cut!" The camera crew in the foreground relaxes, smiles, and applauds the take. Realistic water physics, blue-screen soundstage, 4k photorealistic
Solricks tarafından BTS Movie Set ile render
btssetstyle, Create a realistic behind-the-scenes vehicle stunt shoot. The suspended car moves very slightly on its rig with believable weight and inertia while crew members make natural adjustments around the set. The camera operator slowly moves the dolly along the track, technicians monitor the suspended vehicle, and the overhead rig remains stable. Keep all green-screen walls, stunt equipment, camera rigs and visible crew present throughout. Motion should be restrained, physically grounded and documentary-like, as if filmed during a real high-budget action production.
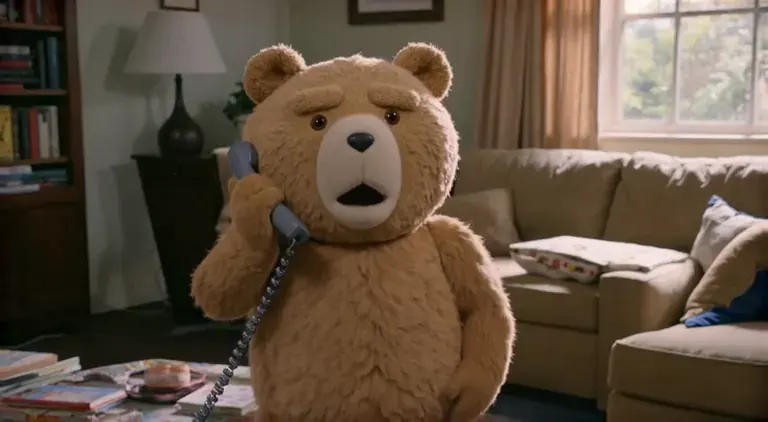
kronos1959777 tarafından Immediate Scene Transition [LTX 2.3] ile render
closeup of Ted_Bear in his living room on the phone saying, \"oh god, Jeffrey, you're in prison!?\" immediate scene transition to the same person (Ted_Bear) inside a prison visitor room talking to an unseen figure. After the scene transition, Ted_Bear is saying, \"Oh, Jeffrey, thank god you're doing okay. Are they treating you well here? I can't imagine my good friend Jeffrey ending up in a place like this. You've always been so good to people, especially ***.
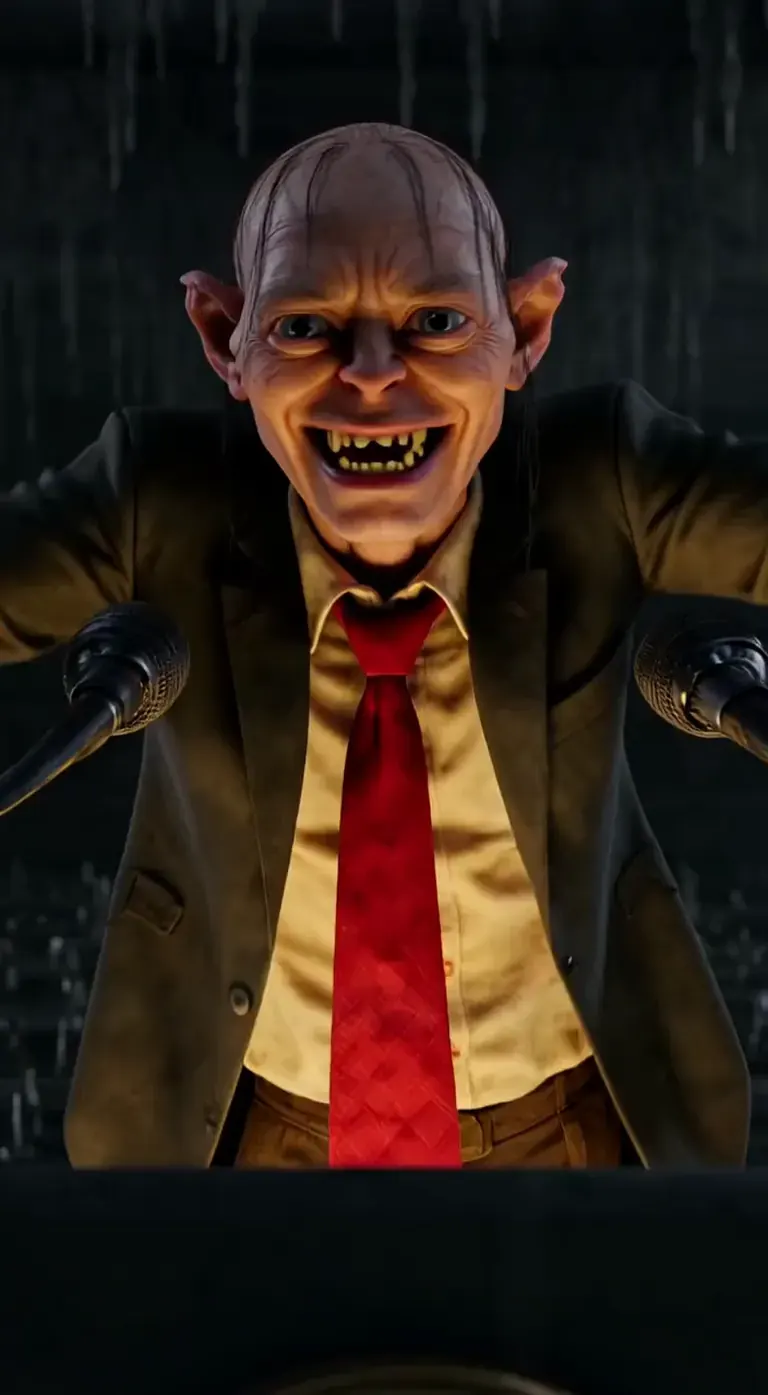
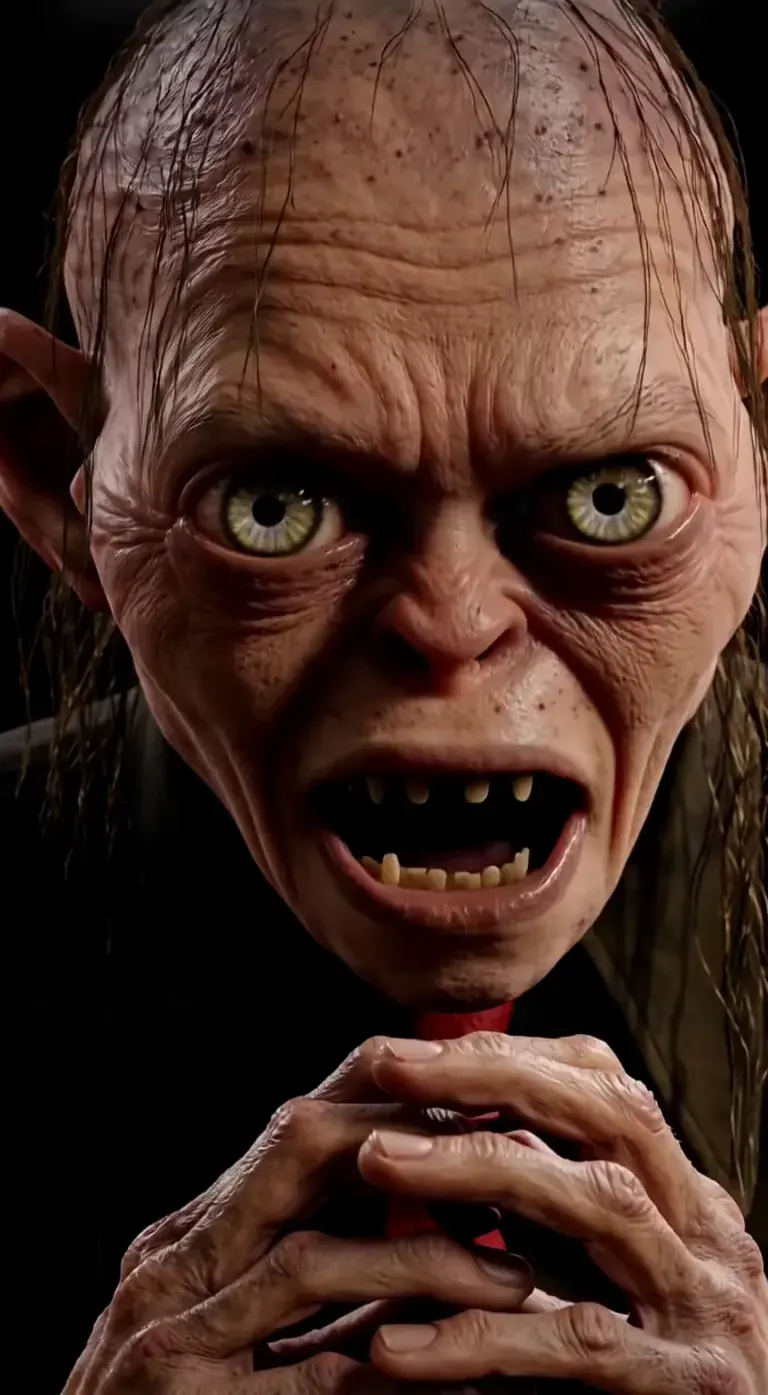
Prompt by playtime_ai_ · Gollum - LTX-2
Every time I hear trump speak, this is how I see it in my head... It really isn't fair to Gollum though. At least Gollum has redeeming qualities. Anyway, Donald Trump really said this dumb shite. Enjoy!
playtime_ai_ tarafından Gollum - LTX-2 ile render
Every time I hear trump speak, this is how I see it in my head... It really isn't fair to Gollum though. At least Gollum has redeeming qualities. Anyway, Donald Trump really said this dumb shite. Enjoy!
 Renderlar ve promptlar, AI görsel ve video modelleri kataloğu ModelTrends'ten.
Seçenekler
| Seçenek | Eşlenir | Varsayılan |
|---|---|---|
(image) | Load Image → image | — |
(prompt) | CLIP Text Encode → text | — |
/guidance | KSampler → cfg | 3 |
/length | LTXV Img To Video → length (frames) | 1200 |
/seed | KSampler → seed | random |
/size | LTXV Img To Video → width, height | 640 × 640 |
/slot1 | Prompt Enhancer → enhance (1 = on) | 0 |
/steps | KSampler → steps | 30 |
Kullanılan modeller
 Animate LTX-2.5
Model, ModelTrends'ten
/run:animate-ltx25 kısa koduyla içe aktarıldı
ModelTrends'te gör
Geliştiriciler için (isteğe bağlı)
Örnek API kodu. Bu iş akışıyla kişisel kullanım için kendi uygulamanı oluşturabilirsin. Dünyaya dağıtmaya hazır olduğunda yüksek erişilebilirlik sunucuları için Bize ulaş. Tam API dokümantasyonunu görmek için tam render API dokümantasyonu.
curl https://cloud.graydient.ai/api/v3/render/ \
  -X POST \
  -H "Content-Type: application/vnd.api+json" \
  -H "Accept: application/vnd.api+json" \
  -H "Authorization: Bearer $GRAYDIENT_TOKEN" \
  -d '{
    "prompt": "/workflow /run:animate-ltx25 /size:640x640 /length:1200 a parrot and a pirate are singing. the lyrics are about booze, pizza, generative ai, pirate, diffusion, \"making longer videos in one shot prompts is now possible\"",
    "callback_url": "https://example.com/webhook/render"
  }'
İşleyiş arkada böyle gerçekleşir. Bu senin için zaten yapılandırıldı. Yukarıdaki tabloda yer alan parametreler bu yuvalara bağlanır, böylece nasıl çalıştığını ve hangi modellerin yükleneceğini değiştirebilirsin. Bunu anlaman veya değiştirmen gerekmez - zaten çalışıyor ve ayarlanmış durumda.
Salt okunur görünüm. Vurgulanan seçenekler, bir çağrının ayarlayabileceği seçeneklerdir. Doğal istem kullanımı; sesi ve hareketi tanımla.
Tüm iş akışları: Güçlü İş Akışları